robots.txt로 AI 학습 허용 여부 지정, 구글·MS 등 공통 규격
OpenAI, 구글, 마이크로소프트, Anthropic이 robots.txt로 AI 학습 허용 여부를 지정하는 공통 규격을 마련한다. 2027년 도입이 목표다.
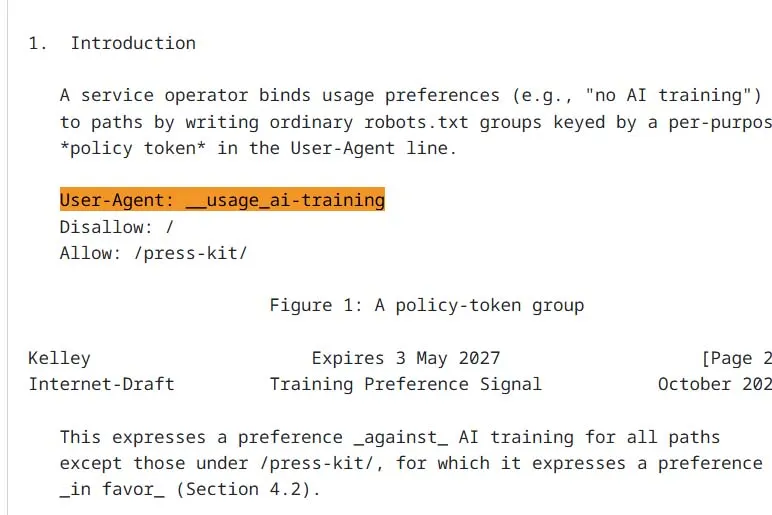
OpenAI, 구글, 마이크로소프트, Anthropic은 웹사이트 운영자가 robots.txt를 통해 AI 학습 허용 여부 등을 지정할 수 있는 공통 규격을 마련한다고 발표했습니다. 2027년 도입을 목표로 합니다.
robots.txt는 검색엔진 등 크롤러(사이트에서 정보를 수집하는 시스템)의 접근 가능 여부를 알려 주는 파일입니다. 그러나 AI 서비스에서는 robots.txt를 무시하고 정보를 수집하는 사례가 많아, 일본신문협회 등도 문제로 지적해 왔습니다.
운영자 부담 줄이는 것이 목표
지금까지 운영자는 크롤러를 하나씩 식별하고 기업별로 규칙을 관리해야 했습니다. 이번 공통 규격은 업계 공통 신호를 지원해 이러한 부담을 덜겠다는 취지입니다. 구글에 따르면 사이트 소유자는 robots.txt에서 공유 '정책 토큰'을 사용해 참여 AI 사업자 전체에 적용되는 설정을 지정할 수 있게 됩니다.
구글의 예로는 'Google-Extended'를 이용해 검색 크롤링은 허용하면서 Gemini 학습은 거부하는 설정이 있습니다. 이런 설정을 robots.txt의 공통 체계로 정비하는 것이 이번 작업입니다.
기업별 도입 시기
규격은 Internet Engineering Task Force(IETF)의 AI Preferences 워킹그룹에서 논의해 만듭니다. 구글은 2027년 도입을 예정하고 있고, OpenAI는 수개월 안에, 마이크로소프트는 2027년 2월부터 적용할 방침입니다.
공통 규격이 마련된 뒤에도 각 사의 고유한 크롤러 제어는 유지됩니다. 구글은 더 세밀한 설정에 Google-Extended를 계속 활용하고, 마이크로소프트는 페이지 단위 학습 설정과 별도의 그라운딩 설정을 추가할 계획입니다.
같은 날의 다른 뉴스
전체 보기 →
관련 카테고리: AI
전체 보기 →
SK텔레콤 AX 2.0 추진, 조직 전체를 AI 중심으로 재설계
마음AI, 월드모델 결합 로봇 AI로 RoboMME 성공률 67.42%
Proton CEO, 개발자에게 AI 생성 코드 확대 요구