robots.txt et IA : Google, OpenAI et Microsoft unifient les règles
OpenAI, Google, Microsoft et Anthropic préparent une spécification commune permettant aux sites d'autoriser ou de refuser l'entraînement des IA via robots.txt.
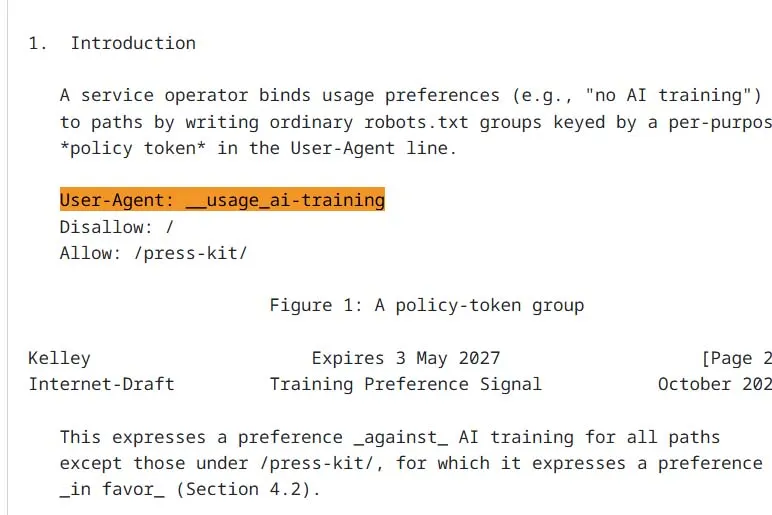
OpenAI, Google, Microsoft et Anthropic ont annoncé l'élaboration d'une spécification commune permettant aux éditeurs de sites d'indiquer dans le fichier robots.txt si leurs contenus peuvent servir à l'entraînement d'IA. Son déploiement est visé pour 2027.
Le fichier robots.txt indique aux robots d'exploration, ces programmes qui collectent automatiquement des informations, quelles pages ils peuvent consulter. Les exploitants peuvent ainsi autoriser ou bloquer les services de recherche et d'IA. Dans les faits, les services d'IA ignorent pourtant souvent ce fichier, un problème dénoncé notamment au Japon par l'association de la presse.
Un signal commun plutôt que de multiples règles
Jusqu'ici, les éditeurs devaient identifier chaque robot séparément et gérer des règles propres à chaque entreprise. Cette initiative vise à alléger cette charge grâce à un signal partagé par toute la filière.
Selon Google, les propriétaires de sites pourront utiliser dans le robots.txt un « jeton de politique » commun, valable pour l'ensemble des fournisseurs d'IA participants. Google cite son mécanisme actuel Google-Extended : un éditeur peut ainsi laisser l'exploration pour la recherche tout en refusant l'entraînement de Gemini. L'objectif est de faire de ce type de réglage un mécanisme commun de robots.txt.
La spécification sera débattue et rédigée au sein du groupe de travail « AI Preferences » de l'Internet Engineering Task Force (IETF).
Calendrier et contrôles propres à chaque acteur
Google prévoit une mise en œuvre en 2027. OpenAI vise les prochains mois, et Microsoft appliquera la norme dès février 2027.
Les entreprises conservent par ailleurs leurs propres contrôles d'exploration. Chez Google, les réglages plus fins passeront toujours par Google-Extended, tandis que Microsoft ajoutera des paramètres d'entraînement par page et un réglage distinct pour le grounding.
Pour les éditeurs, une consigne unique pourrait simplifier la gestion. Reste à voir si les robots la respecteront réellement.
Plus d'actus de ce jour
Tout voir →
Amazon Echo Time, Dot et Studio : trois nouveaux appareils Alexa Plus
Google suspend ses chantiers en Finlande après 250 000 arbres abattus
Apple : John Ternus défend la position du groupe sur l'IA
Reliance Retail étend JioMart avec prudence et vise la rentabilité en FY28
Plus dans: IA
Tout voir →
SK Telecom lance AX 2.0 pour réorganiser le travail autour de l'IA
Maum AI : PonderPounce-WM atteint 67,42 % de réussite sur RoboMME
Proton : le PDG Andy Yen exige davantage de code généré par IA