DeepSeek V4.1 Flash jetzt in Selectels Token Factory verfügbar
Selectel hat DeepSeek V4.1 Flash in Token Factory aufgenommen. Das offene Modell bietet eine Million Token Kontext und läuft in russischen Rechenzentren.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Selectel hat DeepSeek V4.1 Flash in den Katalog von Token Factory aufgenommen, seinem Inferenzdienst mit Abrechnung pro Token. Das Modell ist das Oktober-Update des offenen Modells des chinesischen Labors DeepSeek; die Gewichte erschienen am 17. Oktober unter MIT-Lizenz. Es läuft über dieselbe OpenAI-kompatible API wie der übrige Katalog, die Anfragen werden in russischen Rechenzentren verarbeitet.
Das leistet das Modell
DeepSeek aus Hangzhou hat mit offenen Modellen schon mehrfach die API-Preise gedrückt. Die Basisversion V4.1 Flash erschien im September, die Version 1017 bezeichnet das Unternehmen selbst als kleines Update. Es handelt sich um ein Mixture-of-Experts-Modell mit 763 Milliarden Parametern, von denen pro erzeugtem Token etwa 16 Milliarden aktiv sind, also rund 2 Prozent des Netzes. Deshalb antwortet ein Modell dieser Größe so schnell wie deutlich kleinere.
Das wichtigste technische Merkmal ist der sparsame KV-Cache: In FP4 belegt er 890 Byte pro Token, ein Viertel des Werts von V4 Flash. So lässt sich der Speicher bei einem Kontext von einer Million Token effizient skalieren; das Fenster ist 2,7-mal größer als bei V4 Flash. Das Modell ist multimodal, Bilder verarbeitet der eigens trainierte Encoder DeepSeek-ViT. DeepSeek verspricht bessere Benchmark-Ergebnisse, schnellere Aufgabenerledigung und kürzere Antworten, was bei der Abrechnung pro Token zählt. Laut Technikbericht stieg der Wert bei Terminal-Bench um 11 Punkte, und in Tests zu Automatisierung und Webentwicklung übertraf das leichte Flash das schwerere Opus.
Kosten und Datenschutz
Eine typische Agentenanfrage mit 50.000 Eingabe- und 2.000 Ausgabetokens kostet ohne Cache etwa 13 Rubel. Treffen 40.000 Eingabetokens den Cache, etwa wiederholte Systemprompts und Werkzeugbeschreibungen, sinken die Kosten auf rund 5,8 Rubel.
Die Faustregel: Für Chats, Klassifikation und Massenverarbeitung von Text bleibt V4 Flash günstiger; die Version 1017 lohnt sich, wenn ein ganzes Repository, ein langer Verlauf oder gescannte Dokumente im Speicher bleiben sollen. Alle Anfragen bleiben in russischer Infrastruktur. Laut Dokumentation werden Prompts und Antworten weder gespeichert noch zum Training genutzt; erfasst wird nur technische Verbrauchsstatistik. Für Projekte mit personenbezogenen Daten dürfte das das wichtigste Argument für lokale Inferenz gegenüber der direkten DeepSeek-API sein.
Im Bedienfeld unter Produkte → Token Factory einen API-Schlüssel erstellen und im Modellkatalog den Alias deepseek-v4.1-flash-1017 kopieren. Da die API OpenAI-kompatibel ist, genügt im bestehenden Code ein neuer base_url und Modellname. DeepSeek empfiehlt für temperature und top_p jeweils 1,0.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Shield AI übernimmt Radarhersteller Echodyne für 5,3 Mrd. Dollar
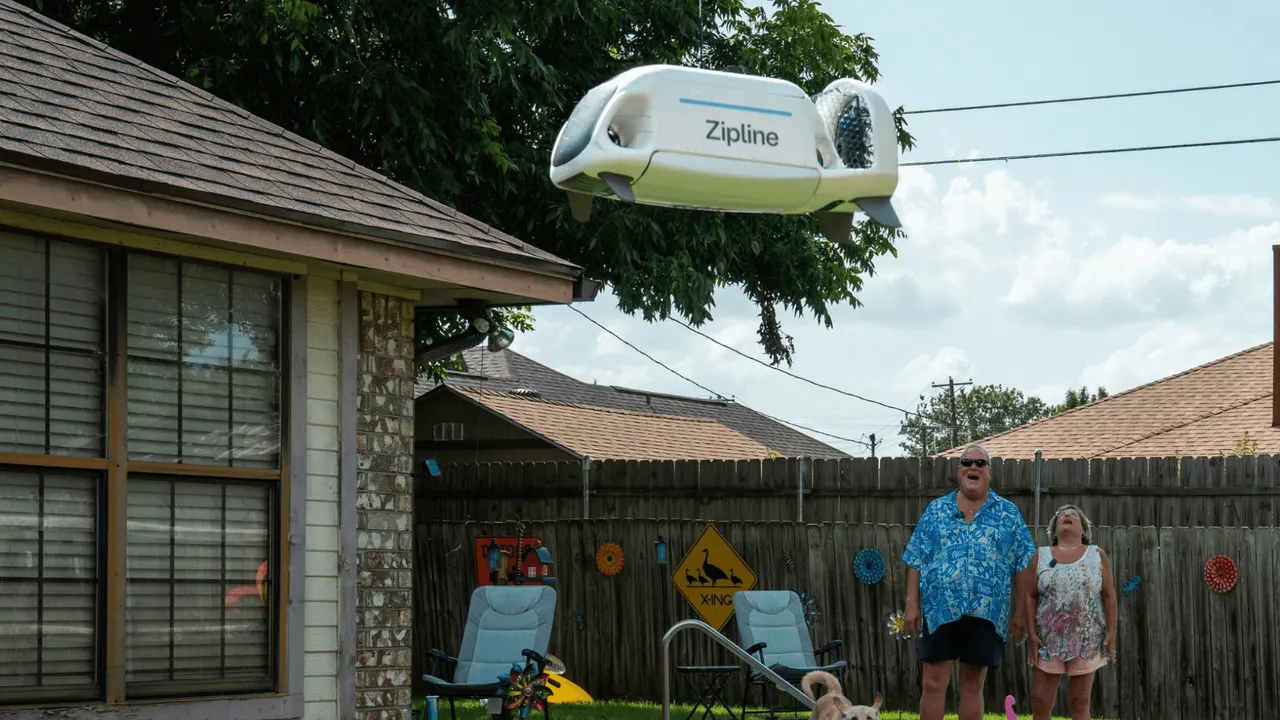
Zipline sammelt 1,5 Milliarden Dollar für Drohnenlieferungen ein
Russlands Zentralbank erlaubt Bitcoin, Ethereum und USDT an Börsen

Beget nach Cyberangriff: Über 60 % des Hostings wieder online
Mehr aus: KI
Alle anzeigen →
NCBR stellt 25 Mio. Zloty für internationale KI-Projekte bereit
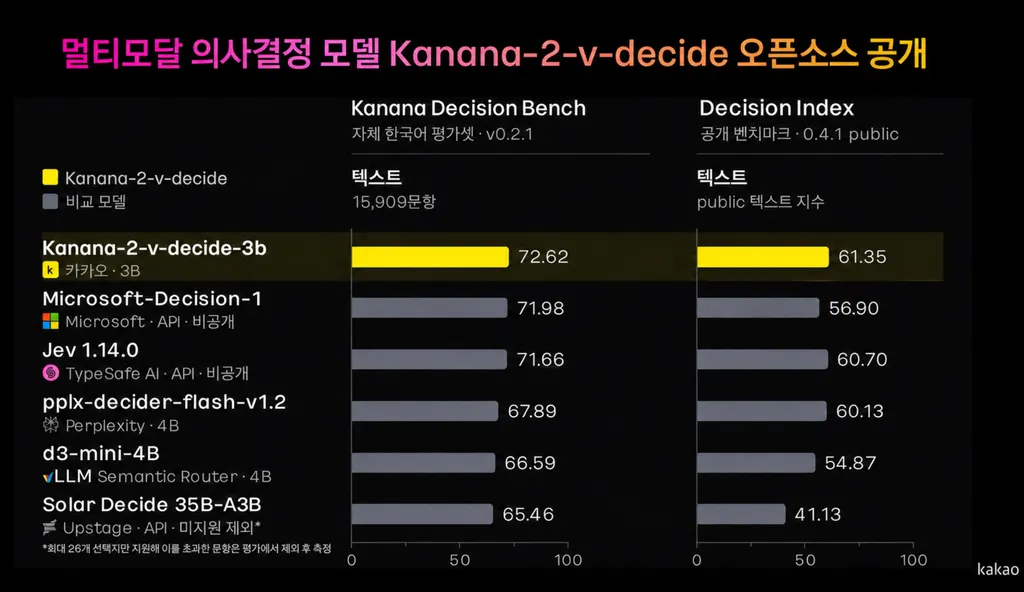
Kakao veröffentlicht Kanana-2-v-decide als Open-Source-Entscheidungsmodell
Airbnb entwickelt KI-Reiseagenten und plant Start für 2027