Nvidia : résumer le contexte préserve les performances des agents IA
Des chercheurs de Nvidia montrent que résumer régulièrement la conversation conserve l'essentiel des performances des agents IA, au risque de remettre en cause les contextes très longs.
 SUMO · le puzzle de nombres
 Dialo · apprenez les langues en parlant
 ediviewer · lisez les fichiers EDI comme des documents
 giftdetect · le bon cadeau en quelques minutes
Les agents d'IA conservent l'essentiel de leurs performances lorsque l'on résume et raccourcit la conversation en cours de tâche. C'est la conclusion de douze chercheurs de Nvidia, dans un article publié le 3 novembre sur arXiv. L'étude remet en cause l'idée selon laquelle plus le contexte est long, meilleur est le résultat.
Le contexte désigne la quantité de conversation et de documents qu'un modèle prend en compte à chaque réponse. Les auteurs constatent que les jetons générés plus tard coûtent plus cher quand le contexte s'allonge. Selon le résumé de l'article, l'écart peut atteindre un facteur 7 pour les modèles récents à poids ouverts. Avec un contexte de 256K plutôt que 16K, le coût par jeton généré était multiplié par 3,6 pour GLM 5.2 de Z.ai, par 5,6 pour Kimi K2.6 de Moonshot AI et par 7 pour Qwen3 Coder Next d'Alibaba.
Ce que montrent les tests
Les chercheurs ont fait résumer leur historique aux agents dès qu'il atteignait une longueur donnée, avant de poursuivre. Ils ont surtout employé Claude Opus 4.5 d'Anthropic et GPT 5.6 Sol d'OpenAI sur six évaluations de tâches longues, dont SWE-bench Verified, Terminal-Bench 2.1, FRAMES et BFCLv3. Sur 22 configurations faisant varier la limite de contexte et le seuil de résumé, cinq au plus perdaient plus de 2 points par rapport à la référence.
Dans le montage où l'agent n'effectue qu'une action par tour et ne transmet qu'un état de tâche compressé, Claude Opus 4.5 passe de 70,0 à 70,2 sur SWE-bench Verified, tandis que GPT 5.6 Sol recule de 84,4 à 82,4. Sur LOONG, 1 600 questions, Claude Opus 4.5 obtient 70,1 en moyenne avec tous les documents, et 38,9 % de réponses parfaites. En sélectionnant et résumant les passages utiles sous 16 000 jetons, il atteint 79,3 et 53,4 %.
Des limites
Les résultats ne sont pas uniformes. En annexe, Qwen3 Coder Next avec résumé à 16K voit son taux de réussite sur SWE-bench chuter de 53,0 % à 3,6 %, un effondrement que l'article qualifie de catastrophique.
Les auteurs proposent aussi un « Semantic State Space Model », qui lit un état de tâche rédigé en langage naturel, agit, puis le réécrit. Ce n'est qu'un concept, ni entraîné ni évalué ici. Selon le résumé, ces résultats interrogent la nécessité des modèles de langage à long contexte.
Des apps à découvrir
SUMO : le puzzle de nombresTouche les bonnes cases, additionne, atteins l'objectif. Facile à apprendre, difficile à maîtriser. Gratuit, pour tous les âges.
Dialo : apprenez les langues en parlantDiscutez avec un partenaire IA ; chaque phrase revient corrigée et expliquée dans votre langue. 9 langues, de A1 à C2.
ediviewer : lisez les fichiers EDI comme des documentsOuvrez des messages EDIFACT et X12, chaque segment expliqué, conversion JSON/XML, export PDF et Excel. Fonctionne en local, sans envoi.
giftdetect : le bon cadeau en quelques minutesChoisissez pour qui, l'occasion et la personnalité. Le moteur lit les descriptions de produits de boutiques locales et classe ce qui convient. Gratuit, sans inscription.
Plus d'actus de ce jour
Tout voir →
La France commande IRIS, ses satellites espions, à Airbus et Thales
Piratage des frigos de supermarchés : les indices contre l’Iran
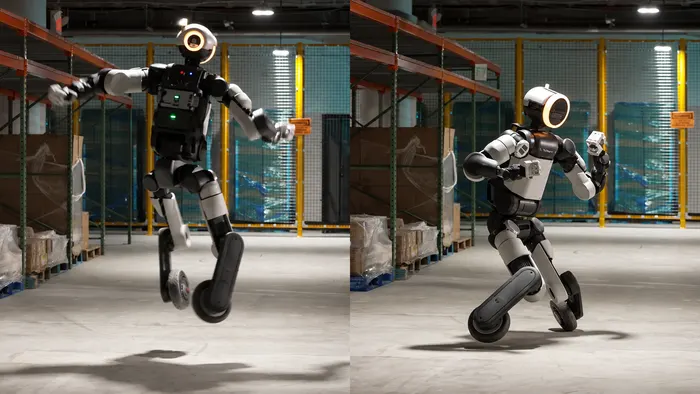
Boston Dynamics : Atlas sur roues réussit un saut à 360 degrés

L'Institut coréen de sécurité financière piraté, des données fuitent
Plus dans: IA
Tout voir →
REA : l'IA démocratise la rétro-ingénierie des TV connectées
Meta dévoile Muse Ember, son plus petit modèle d'IA, à 0,10 $ le million de jetons
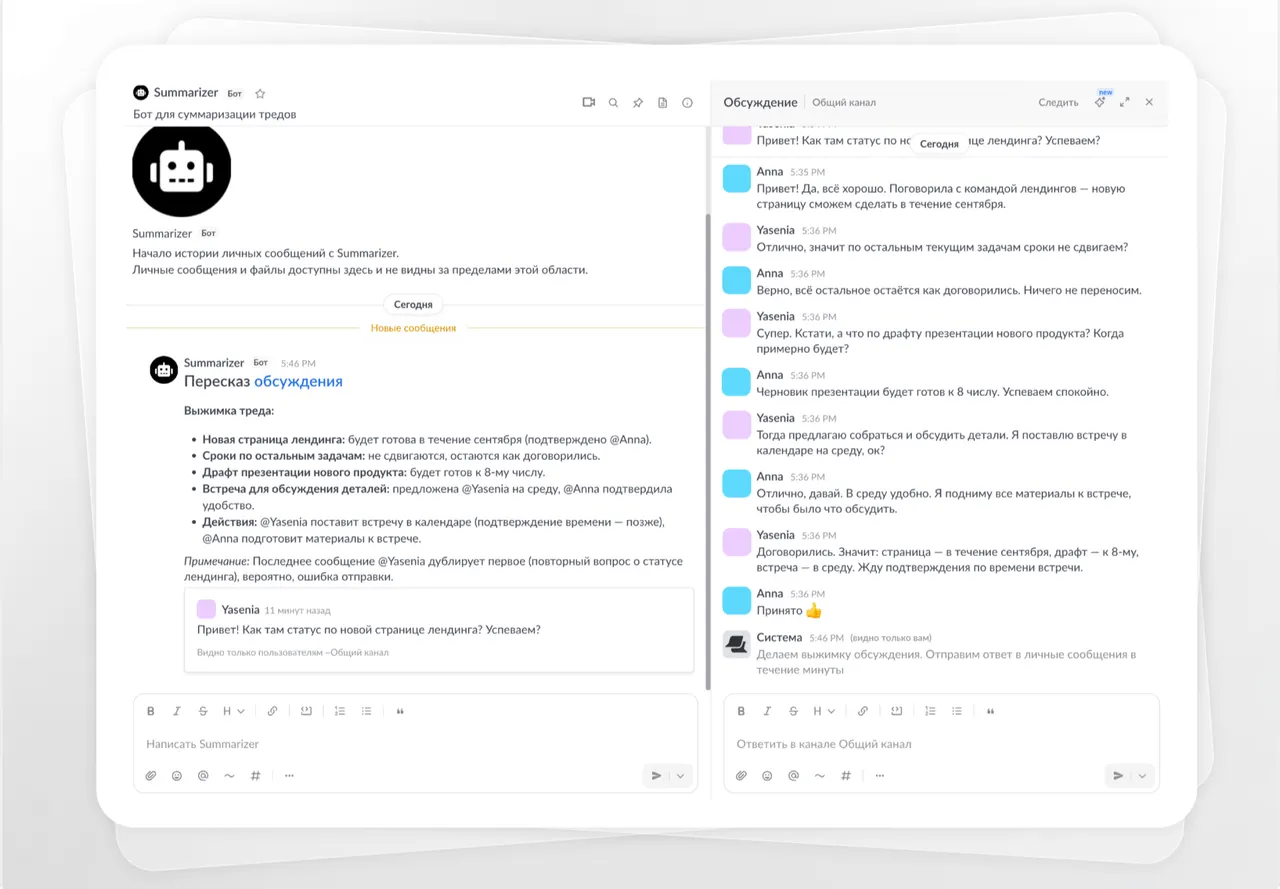
T-Bank : la messagerie Time reçoit un assistant IA et un serveur MCP