robots.txt für KI: Google, OpenAI, Microsoft planen Standard
OpenAI, Google, Microsoft und Anthropic arbeiten an einer gemeinsamen robots.txt-Spezifikation, mit der Website-Betreiber KI-Training erlauben oder untersagen können.
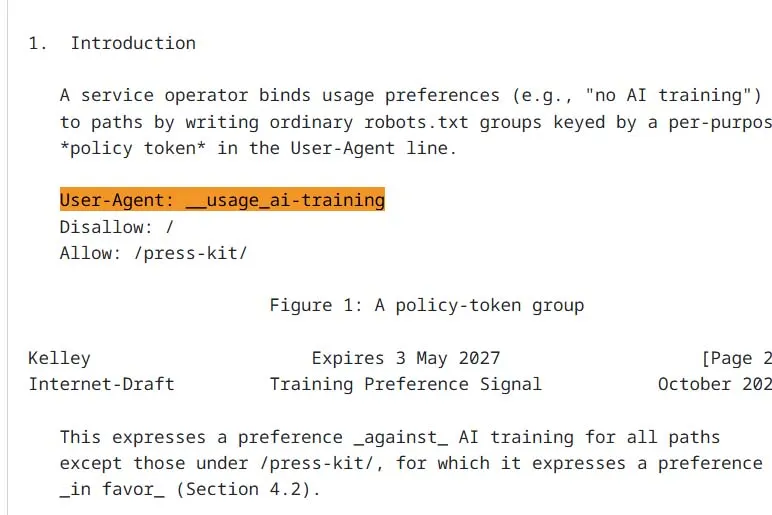
OpenAI, Google, Microsoft und Anthropic entwickeln eine gemeinsame Spezifikation, mit der Website-Betreiber in der robots.txt festlegen können, ob ihre Inhalte für das Training von KI verwendet werden dürfen. Eingeführt werden soll sie 2027.
Die robots.txt teilt Crawlern, also automatischen Programmen zur Informationssammlung, mit, welche Seiten sie abrufen dürfen. Betreiber können damit Such- und KI-Dienste zulassen oder aussperren. In der Praxis ignorieren KI-Dienste die Datei jedoch häufig; in Japan hat unter anderem der Zeitungsverband das Problem kritisiert.
Ein Signal statt vieler Regeln
Bislang mussten Betreiber jeden Crawler einzeln erkennen und für jedes Unternehmen eigene Regeln pflegen. Die neue Initiative soll diesen Aufwand verringern, indem die Anbieter auf ein branchenweit einheitliches Signal reagieren.
Laut Google sollen Website-Eigentümer in der robots.txt ein gemeinsames „Policy Token“ nutzen können, das für alle teilnehmenden KI-Anbieter gilt. Als Beispiel nennt Google den bestehenden Mechanismus Google-Extended: Damit können Publisher das Crawling für die Suche erlauben und zugleich die Nutzung für das Training von Gemini ablehnen. Diese Art der Einstellung soll nun als gemeinsamer Bestandteil der robots.txt etabliert werden.
Die Spezifikation wird in der Arbeitsgruppe „AI Preferences“ der Internet Engineering Task Force (IETF) beraten und erarbeitet.
Zeitplan und eigene Steuerungen
Google plant die Einführung für 2027. OpenAI will den Standard binnen weniger Monate umsetzen, Microsoft wendet ihn ab Februar 2027 an.
Neben dem gemeinsamen Standard behalten die Unternehmen ihre eigenen Crawler-Steuerungen. Feinere Einstellungen laufen bei Google weiterhin über Google-Extended; Microsoft will zusätzlich Trainingseinstellungen auf Seitenebene und eine getrennte Grounding-Option einführen.
Für Publisher könnte eine einheitliche Anweisung die Verwaltung deutlich vereinfachen. Entscheidend bleibt, ob sich die Crawler nach der Einführung tatsächlich daran halten.
Mehr von diesem Tag
Alle anzeigen →
Amazon Echo Time, Dot und Studio: Neue Geräte mit Alexa Plus
Google stoppt Rechenzentren in Finnland nach Rodung von 250.000 Bäumen
Apple-CEO John Ternus gelassen beim Thema KI-Rückstand
Reliance Retail baut JioMart kontrolliert aus und peilt Gewinn ab FY28 an
Mehr aus: KI
Alle anzeigen →
SK Telecom startet AX 2.0: Ganze Teams arbeiten KI-zentriert
Maum AI: Roboter-Modell PonderPounce-WM erreicht 67,42 % bei RoboMME
Proton-Chef Andy Yen verlangt von Entwicklern mehr KI-Code