OpenAI prezentuje Pando – backend Git dla agentów AI
OpenAI zaprezentowało Pando, zgodny z Git backend, który przetwarza około petabajta danych dziennie i niemal pięciokrotnie skraca opóźnienia przy wysyłaniu zmian.
 SUMO· łamigłówka liczbowa
 Dialo· ucz się języków, mówiąc
 ediviewer· czytaj pliki EDI jak dokumenty
 giftdetect· trafiony prezent w kilka minut
OpenAI zaprezentowało Pando – własny backend dla systemu kontroli wersji Git, zaprojektowany z myślą o masowym korzystaniu z asystentów AI. Rozwiązanie jest w pełni zgodne ze standardowymi narzędziami Git, przetwarza dziennie około petabajta danych i niemal pięciokrotnie skraca opóźnienie przy wysyłaniu zmian (push).
Skąd potrzeba nowego serwera
Obciążenie systemu kontroli wersji w OpenAI gwałtownie wzrosło wraz z używaniem narzędzi do automatycznego pisania kodu, takich jak Codex. Według firmy do końca roku liczba kwartalnych commitów w monorepozytorium wzrośnie o ponad 2400%. Tradycyjne serwery Git projektowano dla inżynierów, którzy tworzą dziesiątki lub setki zmian dziennie. Przy stałej pracy asystentów AI liczba commitów i scaleń sięga tysięcy na godzinę.
Niezawodność dotychczasowej infrastruktury spadła poniżej 90%. Zespół zmagał się z wolniejszym pobieraniem i klonowaniem kodu, błędami scalania oraz limitami rozmiaru repozytoriów. Inżynierowie postanowili jednak zachować zgodność z ekosystemem Git, uznając, że problem leży w architekturze tradycyjnych serwerów, a nie w kliencie czy protokole.
Jak działa Pando
Prace nad Pando trwały 10 tygodni. Architekturę zaprojektował jeden inżynier, a implementację w języku Rust wykonały grupy agentów Codex. System działa produkcyjnie od kwietnia.
Twórcy zrezygnowali z dwóch wymagań klasycznych serwerów Git: utrzymywania jednego spójnego stanu wszystkich gałęzi naraz oraz tworzenia osobnego spakowanego pliku (packfile) dla każdego żądania klienta. Zapis do każdej gałęzi obsługiwany jest niezależnie, więc push nie czeka na niepowiązane gałęzie. Przychodzący plik pack trafia do magazynu obiektów BLOB bez rozpakowywania, a informacje o nowym wierzchołku gałęzi, lokalizacji pliku i zależnościach zapisywane są w magazynie metadanych.
Domyślnie jako bazowa deklarowana jest tylko gałąź główna (trunk), co ogranicza rozmiar listy referencji. Kosztem jest ponowne przesyłanie wszystkiego, czego nie ma w trunk, przy kolejnych pushach do tej samej gałęzi. OpenAI uważa to za uzasadniony kompromis, bo mediana rozmiaru pliku pack w ich monorepozytorium wynosi poniżej 20 KB.
Przy pobieraniu Pando przekazuje klientowi linki do zapisanych pakietów przez mechanizm packfile-uri, a usługa cache Express serwuje je z regionalnych pamięci podręcznych o skuteczności powyżej 99%. Na standardowych maszynach wirtualnych klonowanie osiąga limit łącza 10 Gb/s.
Dostępność
Samo Pando nie jest oprogramowaniem open source. Oficjalna zapowiedź odbyła się 2 listopada 2026 roku, a system jest dostępny w ograniczonym podglądzie dla wybranych partnerów korporacyjnych. W pierwszym kwartale 2027 roku planowane jest poszerzenie dostępu komercyjnego z opłatami zależnymi od rozmiaru repozytorium i liczby operacji. Wersja komercyjna obejmie też monitoring udziału kodu generowanego przez AI, częstotliwości konfliktów scalania i tempa wzrostu repozytorium.
Aplikacje warte uwagi
SUMO: łamigłówka liczbowaWybierz właściwe pola, dodaj je i trafiaj w cel. Łatwa do nauczenia, trudna do opanowania. Za darmo, dla każdego wieku.
Dialo: ucz się języków, mówiącRozmawiaj z partnerem AI; każde zdanie wraca poprawione i wyjaśnione w Twoim języku. 9 języków, od A1 do C2.
ediviewer: czytaj pliki EDI jak dokumentyOtwieraj komunikaty EDIFACT i X12, każdy segment objaśniony, konwersja do JSON/XML, eksport PDF i Excel. Działa lokalnie, bez wysyłania.
giftdetect: trafiony prezent w kilka minutWybierz dla kogo, okazję i osobowość. Wyszukiwarka czyta opisy produktów lokalnych sklepów i układa to, co pasuje. Za darmo, bez rejestracji.
Więcej z tego dnia
Zobacz wszystkie →
Journify pozyskuje 12 mln dolarów w rundzie Series A od Al Mada
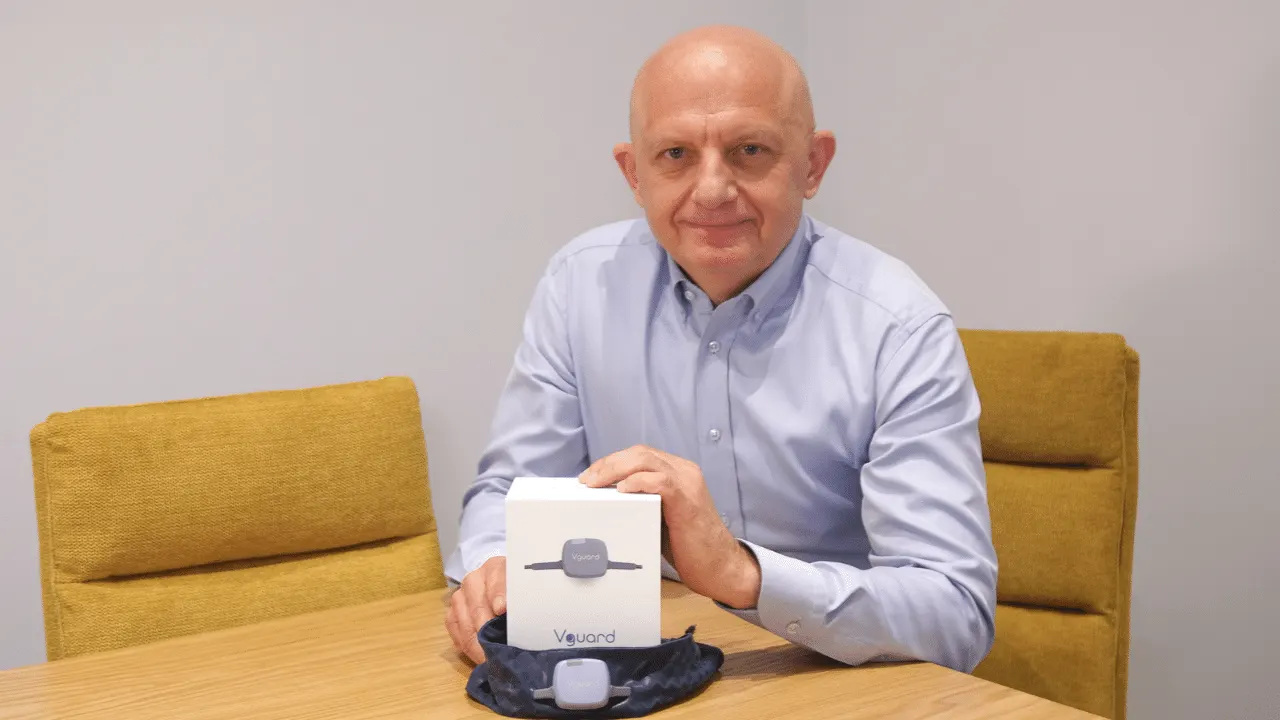
Cogniguard i Vguard: stymulacja nerwu błędnego podczas snu w Alzheimerze
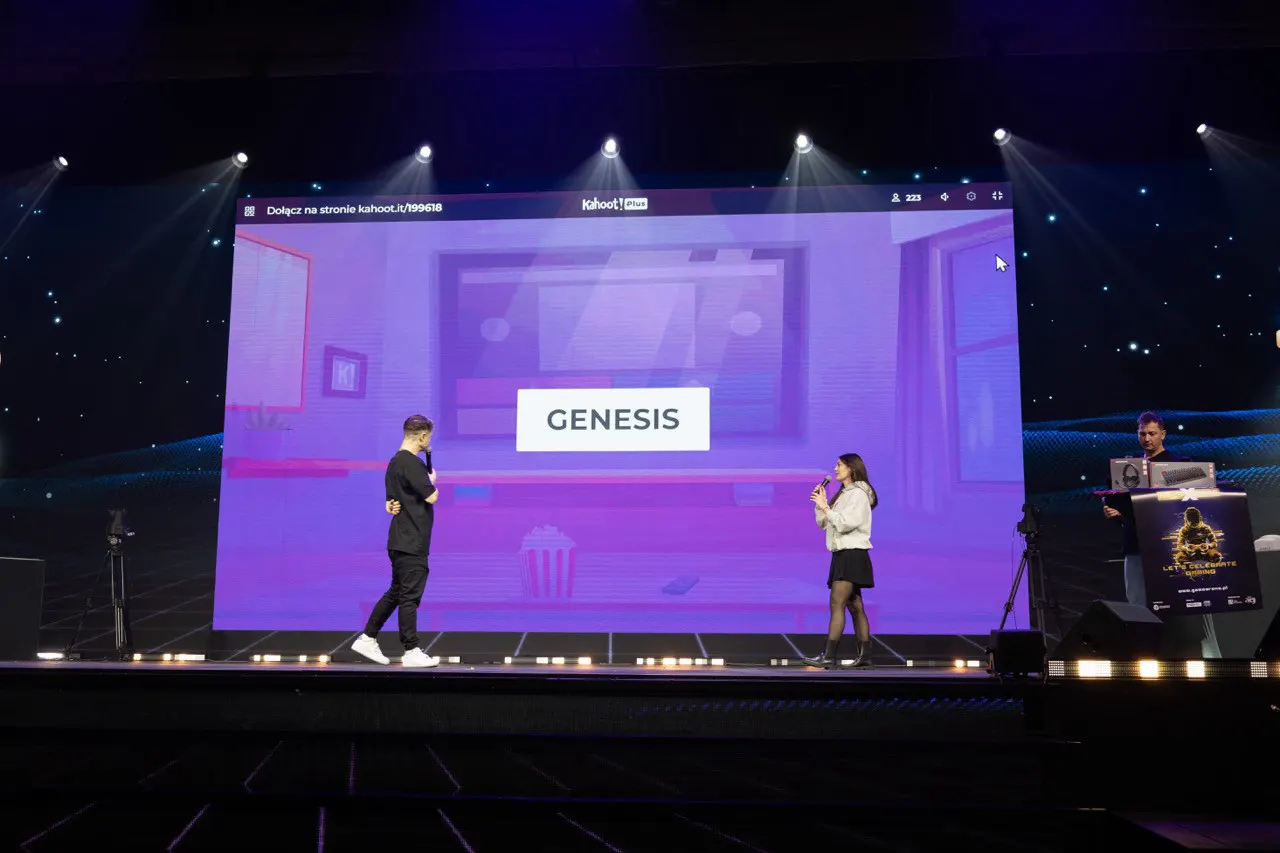
GENESIS ma 15 lat: polska marka gamingowa rozbudowuje siedzibę