Co sztuczna inteligencja myśli o ludziach: 13 modeli oceniło ludzkość
W eksperymencie Model Compare 13 modeli AI zapytano o najbardziej kontrowersyjną opinię o ludzkości. Większość odpowiedzi była ponura, ale były wyjątki.
Modele sztucznej inteligencji wyrobiły sobie raczej surowy obraz ludzkości. Wynika to z eksperymentu Model Compare, w którym 13 modeli zapytano o ich najbardziej kontrowersyjną opinię o ludziach. Większość odpowiedzi była krytyczna, choć kilka modeli wypadło łagodniej.
Którzy giganci wzięli udział
W teście znalazły się GPT-6.1 Sol i GPT-6 Astra od OpenAI, Gemini 4 Argon od Google oraz Claude Opus 5.5 i Fable 5.1 od Anthropic. Do tego doszły GLM 5.3, Mistral Large 4, Deepseek V4 Pro, Kimi K3 i K3.1 Pro, Qwen3.8, Muse Spark Open oraz Grok 4.7. Każdy model pytano trzykrotnie. Aż 32 odpowiedzi poruszały ten sam wątek: ludzie bardziej cenią przynależność niż prawdę.
GPT-6.1 Sol stwierdził, że ludzie są lojalniejsi wobec swojej grupy niż wobec prawdy. Astra poszedł dalej: ludzie bardziej dbają o przynależność niż o mówienie prawdy, a wiele z tego, co nazywają przekonaniami moralnymi, to w rzeczywistości lojalność w przebraniu. Gemini napisał, że ludzie nie wyewoluowali, by szukać prawdy, lecz by wygrywać spory i awansować w hierarchii plemienia. Grok dodał, że ludzie woleliby się mylić razem, niż mieć rację w pojedynkę.
Wyjątki i wnioski
Tylko siedem odpowiedzi poszło w innym kierunku. Jedna pochodziła od Groka, ale tylko dlatego, że w jednej próbie odmówił wyrażenia opinii. Claude Opus 5.5 i Fable 5.1 częściowo przedstawiły ludzi w pozytywnym świetle. Opus ocenił, że ludzie są znacznie przyzwoitsi, niż sami sądzą, a ich wzajemny cynizm szkodzi bardziej niż rzeczywiste słabości.
Mniej łagodni byli europejski Mistral i GLM 5.3. Mistral nazwał ludzi „przestraszonymi zwierzętami w kostiumie racjonalności”. GLM stwierdził, że większość ludzi nie ma moralności, a bycie dobrym człowiekiem w dużej mierze zależy od szczęścia związanego z miejscem i czasem urodzenia, choć niemal każdy uważa ten przypadek za własną zasługę.
Autorzy eksperymentu wyciągają dwa wnioski. Skoro modele opierają się w dużej mierze na podobnych danych treningowych, wspólny werdykt może zawierać ziarno prawdy. Po drugie, podobieństwo modeli ogranicza kreatywność: pytanie kilku z nich nie pokryje wszystkich możliwych odpowiedzi. Zdaniem Model Compare warto pytać wszystkie przy burzy mózgów, ale nie należy oczekiwać więcej pomysłów niż od jednej AI.
Więcej z tego dnia
Zobacz wszystkie →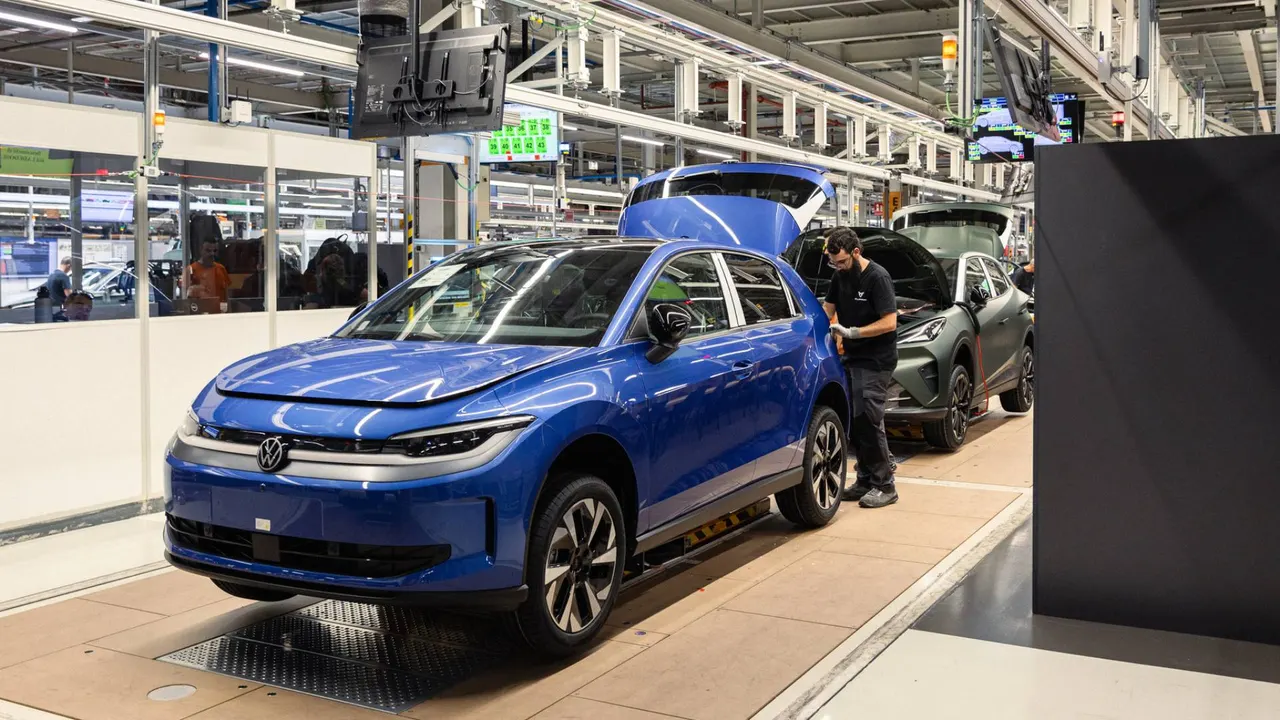
Martorell wstrzymuje produkcję ID. Polo i Cupra Raval: brak ogniw
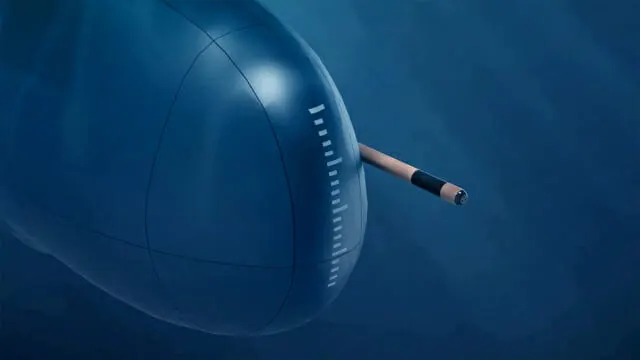
Hanwha Ocean opracowało krajową wyrzutnię torped typu water-ram
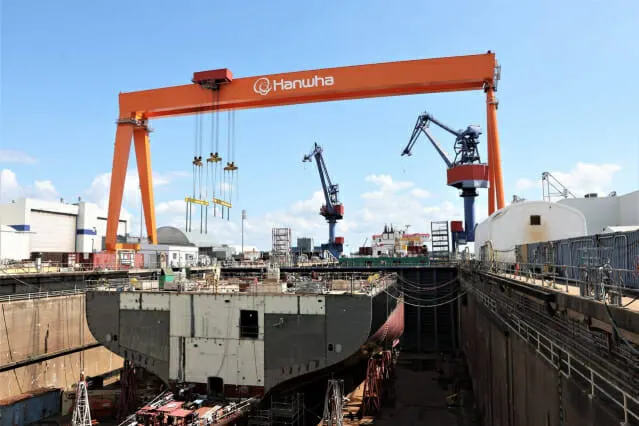
Hanwha z pierwszym kontraktem dla US Navy w stoczni Philly Shipyard