AI学習の可否をrobots.txtで指定、Googleなど4社が共通仕様
OpenAI、Google、Microsoft、Anthropicが、robots.txtでAI学習の可否を指定できる共通仕様の策定を進める。2027年の導入を目指す。
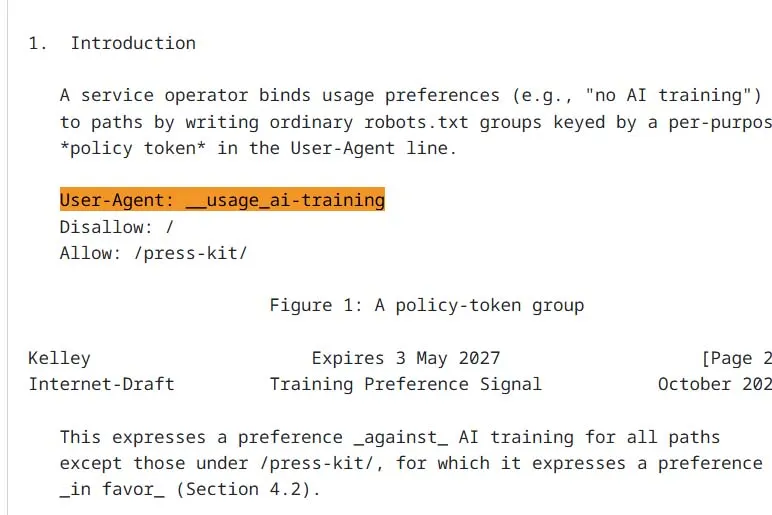
OpenAI、Google、Microsoft、Anthropicは、Webサイトの運営者がrobots.txtを使ってAIの学習可否などを指定できる共通仕様の策定を進めると発表した。2027年の導入を目指す。
robots.txtは、検索エンジンなどのクローラー(サイトから情報を収集する仕組み)に対し、アクセスの可否を示すファイルだ。ただ、AIサービスではrobots.txtを無視して情報を収集するケースも多いとされ、日本の新聞協会なども問題視している。
運営者の負担軽減が狙い
これまで運営者はクローラーを個別に識別し、企業ごとにルールを管理する必要があった。今回の取り組みは、業界共通のシグナルに対応することで、その負担を減らす狙いがある。Googleによると、運営者はrobots.txt内で共有の「ポリシートークン」を使い、参加するAI事業者全体に対する設定を指定できるようになる。
Googleの例では、「Google-Extended」を使うことで、検索のクロールは許可しつつGeminiの学習は拒否する設定が可能だ。こうした設定を、robots.txtの共通の仕組みとして整備する。
各社の導入時期
仕様はInternet Engineering TaskForce(IETF)のAI Preferencesワーキンググループで協議して策定する。Googleは2027年の導入を予定し、OpenAIは今後数カ月以内、Microsoftは2027年2月からの適用を目指す。
共通仕様の策定後も、各社独自のクローラー制御は継続する。Googleはより細かな設定にGoogle-Extendedを活用し、Microsoftはページ単位の学習設定や独立したグラウンディング設定を追加する方針だ。
同じ日のニュース
すべて見る →
関連カテゴリ: AI
すべて見る →
SKテレコム、AX 2.0で組織の働き方をAI中心に再設計
マウムAI、世界モデル搭載ロボットAIがRoboMMEで成功率67.42%
Proton CEO、開発者にAI生成コードの拡大を要求