Tesseract 5 apprend le mansi : les erreurs d'OCR divisées par 20
L'institut russe YuNIIIT a affiné Tesseract 5 pour le mansi imprimé : le taux d'erreur par caractère passe de 18,5 % à 0,85 %. Le modèle est libre sur Hugging Face.
 SUMO · le puzzle de nombres
 Dialo · apprenez les langues en parlant
 ediviewer · lisez les fichiers EDI comme des documents
L'Institut de recherche en technologies de l'information d'Ougra (YuNIIIT) a affiné le moteur libre de reconnaissance de texte Tesseract 5 pour lire le mansi imprimé. Le taux d'erreur par caractère est passé de 18,5 % à 0,85 %, soit une réduction d'environ vingt fois. Le modèle est publié sur Hugging Face et déjà utilisable.
Ce travail s'inscrit dans le projet « Corpus de la langue mansi ». Dans une première étape, l'équipe avait constitué 300 000 phrases parallèles et entraîné un réseau de neurones à traduire entre le russe et le mansi. Vient maintenant la reconnaissance optique de caractères : la plupart des textes mansis, livres, manuels, recueils de folklore ou collections de journaux, n'existent que sur papier. Les retaper à la main est long et coûteux, et les rares locuteurs natifs sont plus utiles pour la traduction et l'expertise.
Pourquoi les OCR classiques échouent
Le mansi s'écrit en cyrillique, avec des signes supplémentaires : des voyelles longues surmontées d'un macron, comme а̄, о̄, ӯ, э̄ et ы̄, ainsi que la lettre ӈ pour le son « ng ». La longueur de la voyelle change le sens, et la perte d'un macron peut transformer un mot en un autre. Le modèle russe standard de Tesseract ignore ces caractères : il perd le trait ou produit du bruit, et se trompe sur environ 18 caractères sur 100. Autre difficulté : Unicode permet de coder la même lettre accentuée de plusieurs façons, identiques à l'écran mais différentes pour un modèle.
Des données d'entraînement synthétiques
Faute de livres mansis numérisés, l'équipe a généré ses propres données. Des scripts Python ont repris de vrais textes mansis issus de publications imprimées et électroniques, les ont normalisés en Unicode NFC, puis rendus dans plusieurs dizaines de polices, dont FreeSerif, DejaVu Sans, Arial, Calibri et Times New Roman, en plusieurs tailles et en graisses normale, grasse et italique.
Chaque caractère a aussi reçu un cadre de délimitation. Les métriques automatiques des polices se trompent souvent pour les lettres à diacritiques ; les chercheurs ont donc appliqué des corrections au pixel près selon le caractère, le corps et la police. Le résultat : 1,3 million de paires composées d'une image de ligne (.tif) et d'un fichier texte de référence (.gt.txt).
La base de départ est le modèle russe officiel rus.traineddata du dépôt tessdata_best. L'alphabet mansi recouvrant largement le russe, le réseau devait surtout apprendre les nouvelles lettres à macron et ӈ.
Des apps à découvrir
SUMO : le puzzle de nombresTouche les bonnes cases, additionne, atteins l'objectif. Facile à apprendre, difficile à maîtriser. Gratuit, pour tous les âges.
Dialo : apprenez les langues en parlantDiscutez avec un partenaire IA ; chaque phrase revient corrigée et expliquée dans votre langue. 9 langues, de A1 à C2.
ediviewer : lisez les fichiers EDI comme des documentsOuvrez des messages EDIFACT et X12, chaque segment expliqué, conversion JSON/XML, export PDF et Excel. Fonctionne en local, sans envoi.
Plus d'actus de ce jour
Tout voir →
Astroteq.ai installe un détecteur de muons sous la colline du Wawel

La Pologne lance un bug bounty national doté d'un million de zlotys
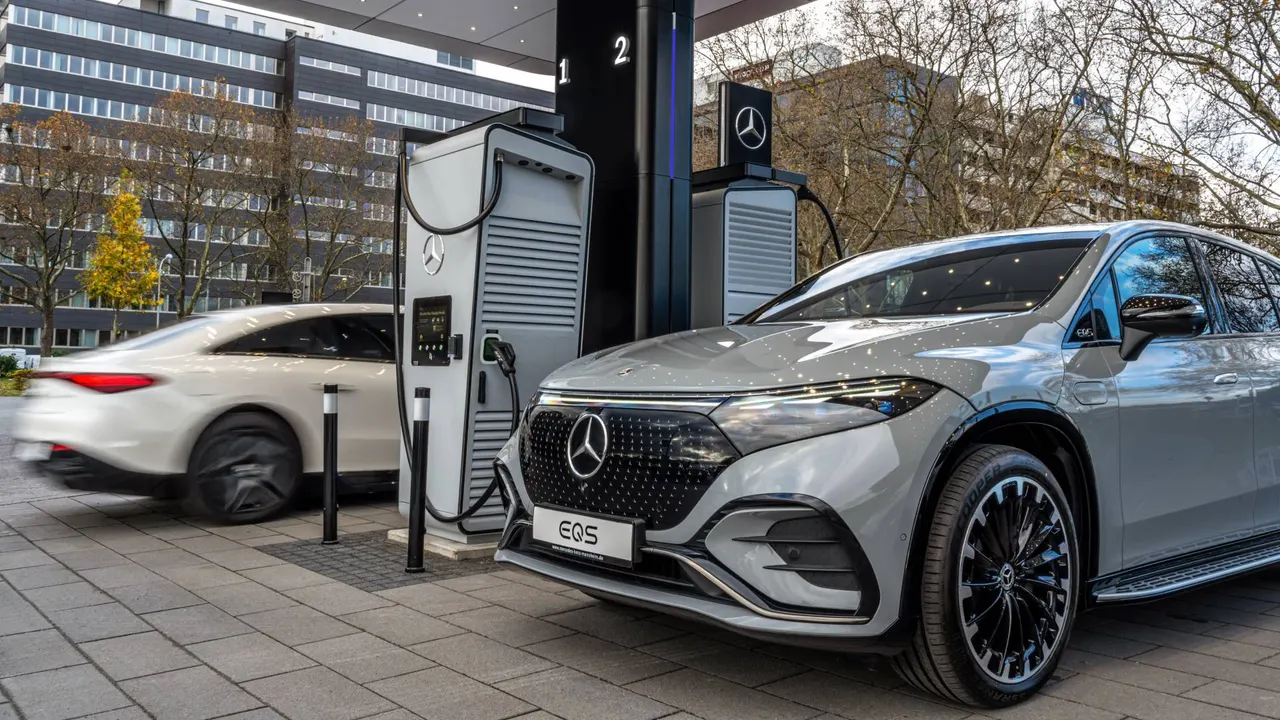
Mercedes-Benz cède son réseau de recharge européen à Electra
Rafale B374 : la DGA reçoit son laboratoire volant du futur F5
Plus dans: IA
Tout voir →
Upstage déploie Solar Pro 4 sur la plateforme d'IA de l'État coréen
ChatGPT Classic : OpenAI fermera l'application le 30 janvier
NC AI dévoile un modèle de vision compact pour l'IA physique