Microsoft et Google soutiennent un refus commun de l'entraînement IA
Microsoft permettra aux sites de bloquer séparément l'entraînement des IA et leur usage dans Bing et Copilot. Google veut soutenir un refus commun fondé sur l'IETF.
Microsoft a annoncé le 30 octobre de nouvelles règles permettant aux propriétaires de sites de contrôler l'usage de leurs contenus dans ses produits d'IA. Ils pourront interdire séparément l'entraînement des modèles et l'utilisation de leurs pages pour générer les réponses de Bing et de Copilot, tout en restant présents dans les résultats de recherche classiques. Le même jour, Google a indiqué vouloir prendre en charge un mécanisme commun de refus de l'entraînement des IA.
Les deux groupes s'appuient sur une norme en cours d'élaboration à l'IETF. Elle doit permettre aux éditeurs de définir des restrictions pour plusieurs fournisseurs d'IA à la fois, au lieu de rédiger des règles propres à chaque robot d'exploration.
Deux réglages distincts
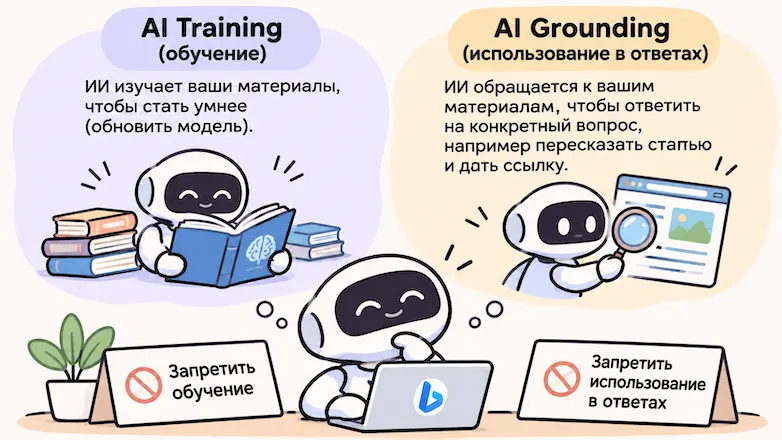
Microsoft distingue l'AI Training de l'AI Grounding. Dans le premier cas, textes, images et autres contenus servent à entraîner des modèles, qui peuvent ensuite restituer ce qu'ils ont appris sans consulter la source. Dans le second, l'IA consulte une page pour répondre à une question précise, par exemple en résumant un article, en reprenant ses faits et en citant la source.
L'entraînement peut être interdit pour tout un site avec deux lignes dans le fichier robots.txt. Cela n'affecte pas l'indexation : le site reste visible dans Bing tant que son exploration n'est pas bloquée. Le grounding ne se règle pas dans robots.txt, mais via une balise meta dans le code HTML ou un en-tête de réponse HTTP, renvoyé sur chaque page pour couvrir tout le site. Une option intermédiaire, ai-grounding:disallowextended, autorise les produits de Microsoft, dont Copilot, mais interdit la transmission à des développeurs tiers via des services comme Web IQ et Foundry API.
Les deux restrictions sont indépendantes. Sans indication, Microsoft considère les deux usages comme autorisés.
Calendrier et limites
Les règles s'appliqueront à partir du 1er février 2027, au fil de la nouvelle exploration des sites. Les éditeurs utilisant les anciens réglages NoArchive et NoCache disposent d'une période de transition jusqu'au 1er mars 2027 pour les remplacer. Maintenir une interdiction de grounding avant la réindexation peut exiger un réglage temporaire dans Bing Webmaster Tools.
Google prévoit une prise en charge au cours de 2027. Si un site interdit l'entraînement avec la nouvelle directive sans règle propre à Google-Extended, Google considérera l'entraînement comme interdit ; les réglages Google-Extended explicites resteront prioritaires. Google n'a pas annoncé de soutien au contrôle du grounding proposé par Microsoft.
Le projet de l'IETF n'est pas encore une norme approuvée, et ces directives expriment une préférence, non une protection technique : leur respect dépend des entreprises. Microsoft avertit qu'interdire le grounding réduira la présence du site dans les réponses IA et le trafic potentiel. Aucune compensation n'est prévue.
Des apps à découvrir
 SUMO : le puzzle de nombres
Touche les bonnes cases, additionne, atteins l'objectif. Facile à apprendre, difficile à maîtriser. Gratuit, pour tous les âges.
 Dialo : apprenez les langues en parlant
Discutez avec un partenaire IA ; chaque phrase revient corrigée et expliquée dans votre langue. 9 langues, de A1 à C2.
 ediviewer : lisez les fichiers EDI comme des documents
Ouvrez des messages EDIFACT et X12, chaque segment expliqué, conversion JSON/XML, export PDF et Excel. Fonctionne en local, sans envoi.
Plus d'actus de ce jour
Tout voir →TVS Motor garde la tête des deux-roues électriques en Inde
Meesho mise sur la publicité et le crédit pour monétiser sa base
Huawei refond l'AppGallery de ses montres connectées