Microsoft y Google respaldan un veto común al entrenamiento de IA
Microsoft permitirá a los sitios bloquear por separado el entrenamiento de IA y su uso en Bing y Copilot. Google apoyará un veto común basado en el estándar del IETF.
Microsoft anunció el 30 de octubre nuevas reglas para que los propietarios de sitios web controlen cómo se usa su contenido en los productos de IA de la compañía. Podrán prohibir por separado el entrenamiento de modelos y el uso de sus páginas para generar respuestas en Bing y Copilot, sin dejar de aparecer en los resultados de búsqueda habituales. Ese mismo día, Google comunicó que también pretende respaldar un mecanismo común para vetar el entrenamiento de IA.
Ambas empresas se guían por un estándar que se desarrolla en el IETF. Permitiría a los editores fijar restricciones para varios proveedores de IA a la vez, en lugar de escribir reglas distintas para cada rastreador.
Dos controles independientes
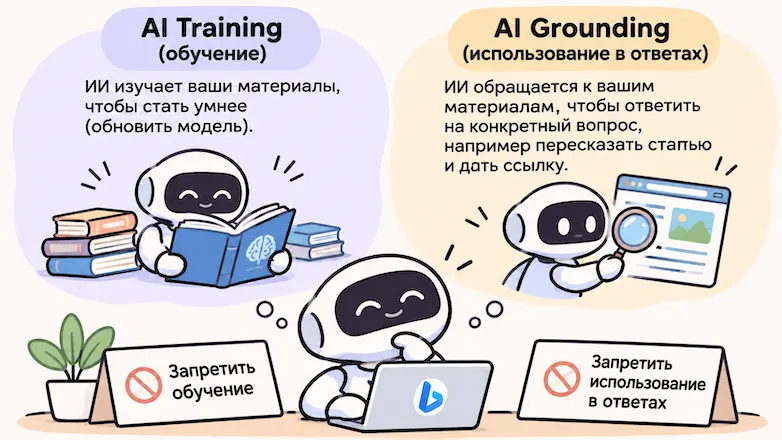
Microsoft diferencia entre AI Training y AI Grounding. En el primero, textos, imágenes y otros materiales sirven para entrenar modelos, que luego pueden reproducir lo aprendido sin acudir a la fuente. En el segundo, la IA consulta una página para responder una pregunta concreta, por ejemplo resumiendo un artículo, usando sus datos y enlazando la fuente.
El entrenamiento puede prohibirse en todo el sitio con dos líneas en robots.txt. Esto no afecta a la indexación: el sitio seguirá en Bing mientras no se bloquee su rastreo. El grounding no puede configurarse en robots.txt, pero sí con una metaetiqueta en el HTML o con una cabecera de respuesta HTTP, que puede devolverse en cada página para cubrir todo el sitio. Una opción intermedia, ai-grounding:disallowextended, permite los productos propios de Microsoft, como Copilot, pero impide ceder el contenido a desarrolladores externos mediante servicios como Web IQ y Foundry API.
Las dos restricciones son independientes. Si el propietario no indica nada, Microsoft considera permitidos ambos usos.
Calendario y límites
Las reglas entrarán en vigor el 1 de febrero de 2027, a medida que se vuelvan a rastrear los sitios. Quienes usan los ajustes anteriores NoArchive y NoCache tienen un periodo de transición hasta el 1 de marzo de 2027 para sustituirlos. Mantener la prohibición de grounding hasta la reindexación puede requerir un ajuste temporal en Bing Webmaster Tools.
Google prevé incorporar el soporte durante 2027. Si un sitio prohíbe el entrenamiento con la nueva directiva y no define reglas para Google-Extended, Google lo considerará vetado también para su mecanismo; los ajustes explícitos de Google-Extended tendrán prioridad. La compañía no ha anunciado soporte para el control de grounding de Microsoft.
El proyecto del IETF aún no es un estándar aprobado, y las directivas expresan una preferencia, no una protección técnica, por lo que su cumplimiento depende de las empresas. Microsoft advierte de que bloquear el grounding reducirá la presencia del sitio en las respuestas de IA y el tráfico potencial. Las reglas no contemplan compensación alguna.
Apps que merecen la pena
 SUMO: el puzle de números
Toca las casillas correctas, suma y alcanza el objetivo. Fácil de aprender, difícil de dominar. Gratis, para todas las edades.
 Dialo: aprende idiomas hablando
Conversa con un compañero de IA; cada frase vuelve corregida y explicada en tu idioma. 9 idiomas, de A1 a C2.
 ediviewer: lee archivos EDI como documentos
Abre mensajes EDIFACT y X12, cada segmento explicado, conversión a JSON/XML, exportación a PDF y Excel. Funciona en local, sin subir nada.
Más de este día
Ver todas →TVS Motor mantiene el liderazgo de motos eléctricas en India
Meesho apuesta por la publicidad y el crédito para monetizar
Huawei renueva AppGallery en sus relojes inteligentes