Nvidia: streszczanie kontekstu nie psuje wydajności agentów AI
Badacze Nvidii wykazali, że okresowe streszczanie rozmowy zachowuje większość skuteczności agentów AI i może obniżyć koszty długiego kontekstu.
 SUMO· łamigłówka liczbowa
 Dialo· ucz się języków, mówiąc
 ediviewer· czytaj pliki EDI jak dokumenty
 giftdetect· trafiony prezent w kilka minut
Im dłuższy kontekst, tym lepszy model? Nowa praca badaczy Nvidii podważa to przekonanie. Dwanaścioro autorów opublikowało 3 listopada w serwisie arXiv artykuł, z którego wynika, że streszczanie rozmowy w trakcie długiego zadania zachowuje większość wydajności agentów AI. Kontekst to ilość rozmowy i materiałów, które model widzi naraz, gdy generuje odpowiedź.
Długi kontekst kosztuje coraz więcej
Badacze zauważyli, że w długim kontekście późniejsze tokeny są droższe od wcześniejszych. Według streszczenia pracy w nowych modelach z otwartymi wagami różnica może sięgać 7 razy. Obsługa kontekstu 256K (ok. 256 tys. tokenów) kosztuje na jeden wygenerowany token 3,6 raza więcej niż 16K w GLM 5.2 od Z.ai, 5,6 raza więcej w Kimi K2.6 od Moonshot AI i 7 razy więcej w Qwen3 Coder Next od Alibaby.
Wyniki testów
Zespół sprawdził metodę, w której po osiągnięciu zadanej długości rozmowa jest streszczana, a praca trwa dalej. Testy obejmowały sześć zadań, m.in. SWE-bench Verified, Terminal-Bench 2.1, FRAMES i BFCLv3, głównie na Claude Opus 4.5 i GPT 5.6 Sol. Spośród 22 konfiguracji z różnymi limitami kontekstu i progami streszczania nie więcej niż pięć obniżyło wynik o ponad 2 punkty. Gdy model wykonywał jedną akcję na rozmowę i przekazywał dalej tylko skompresowany stan zadania, Claude Opus 4.5 uzyskał w SWE-bench 70,2 pkt wobec 70,0, a GPT 5.6 Sol 82,4 pkt wobec 84,4.
W teście LOONG, obejmującym 1600 pytań do wielu długich dokumentów, Claude Opus 4.5 z pełnym materiałem uzyskał średnio 70,1 pkt i 38,9 proc. w pełni poprawnych odpowiedzi. Gdy wybierał potrzebne fragmenty, streszczał je i trzymał kontekst poniżej 16 tys. tokenów, wynik wzrósł do 79,3 pkt i 53,4 proc.
Metoda nie działa jednak na każdym modelu. W dodatku do pracy Qwen3 Coder Next przy streszczaniu w ustawieniu 16K spadł w zadaniach programistycznych z 53,0 proc. do 3,6 proc. — autorzy piszą o „katastrofalnym załamaniu”.
Autorzy proponują też „Semantic State Space Model”, czyli model dotrenowany do czytania opisu stanu zadania w języku naturalnym, działania i przepisywania tego opisu. To na razie tylko koncepcja, niewytrenowana ani nieprzetestowana. Według abstraktu wyniki „podają w wątpliwość potrzebę modeli z długim kontekstem”. Dla firm korzystających z agentów AI oznacza to, że o kosztach i jakości może decydować to, co zostaje w kontekście, a nie jego długość.
Aplikacje warte uwagi
SUMO: łamigłówka liczbowaWybierz właściwe pola, dodaj je i trafiaj w cel. Łatwa do nauczenia, trudna do opanowania. Za darmo, dla każdego wieku.
Dialo: ucz się języków, mówiącRozmawiaj z partnerem AI; każde zdanie wraca poprawione i wyjaśnione w Twoim języku. 9 języków, od A1 do C2.
ediviewer: czytaj pliki EDI jak dokumentyOtwieraj komunikaty EDIFACT i X12, każdy segment objaśniony, konwersja do JSON/XML, eksport PDF i Excel. Działa lokalnie, bez wysyłania.
giftdetect: trafiony prezent w kilka minutWybierz dla kogo, okazję i osobowość. Wyszukiwarka czyta opisy produktów lokalnych sklepów i układa to, co pasuje. Za darmo, bez rejestracji.
Więcej z tego dnia
Zobacz wszystkie →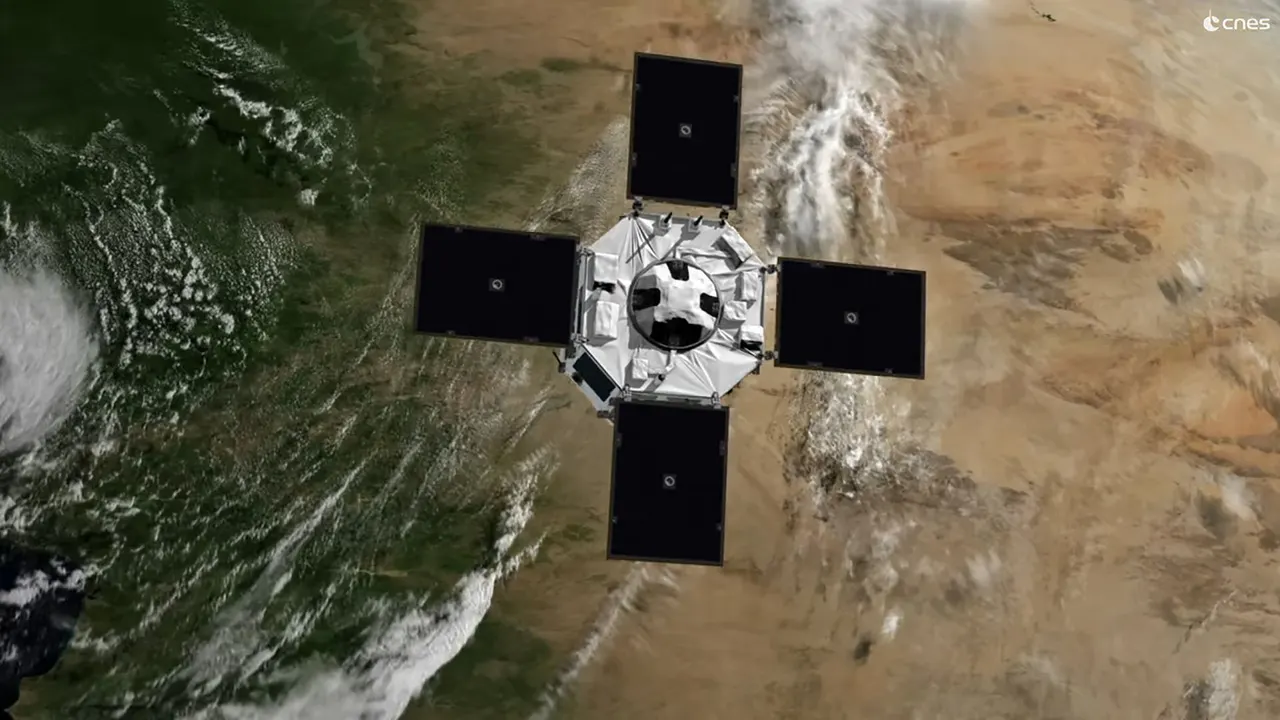
Francja zamawia satelity szpiegowskie IRIS w Airbusie i Thales
Francja oskarża Iran o atak na lodówki w supermarketach
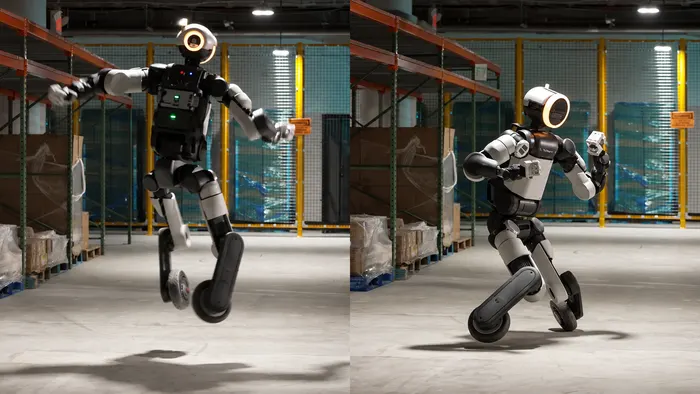
Boston Dynamics daje Atlasowi koła i pokazuje skok o 360 stopni