MeitY proponuje DEPA do trenowania AI z poszanowaniem prywatności
Indyjskie ministerstwo IT zaproponowało oparte na zgodzie ramy DEPA, dzięki którym startupy i badacze trenują modele AI bez dostępu do surowych danych.
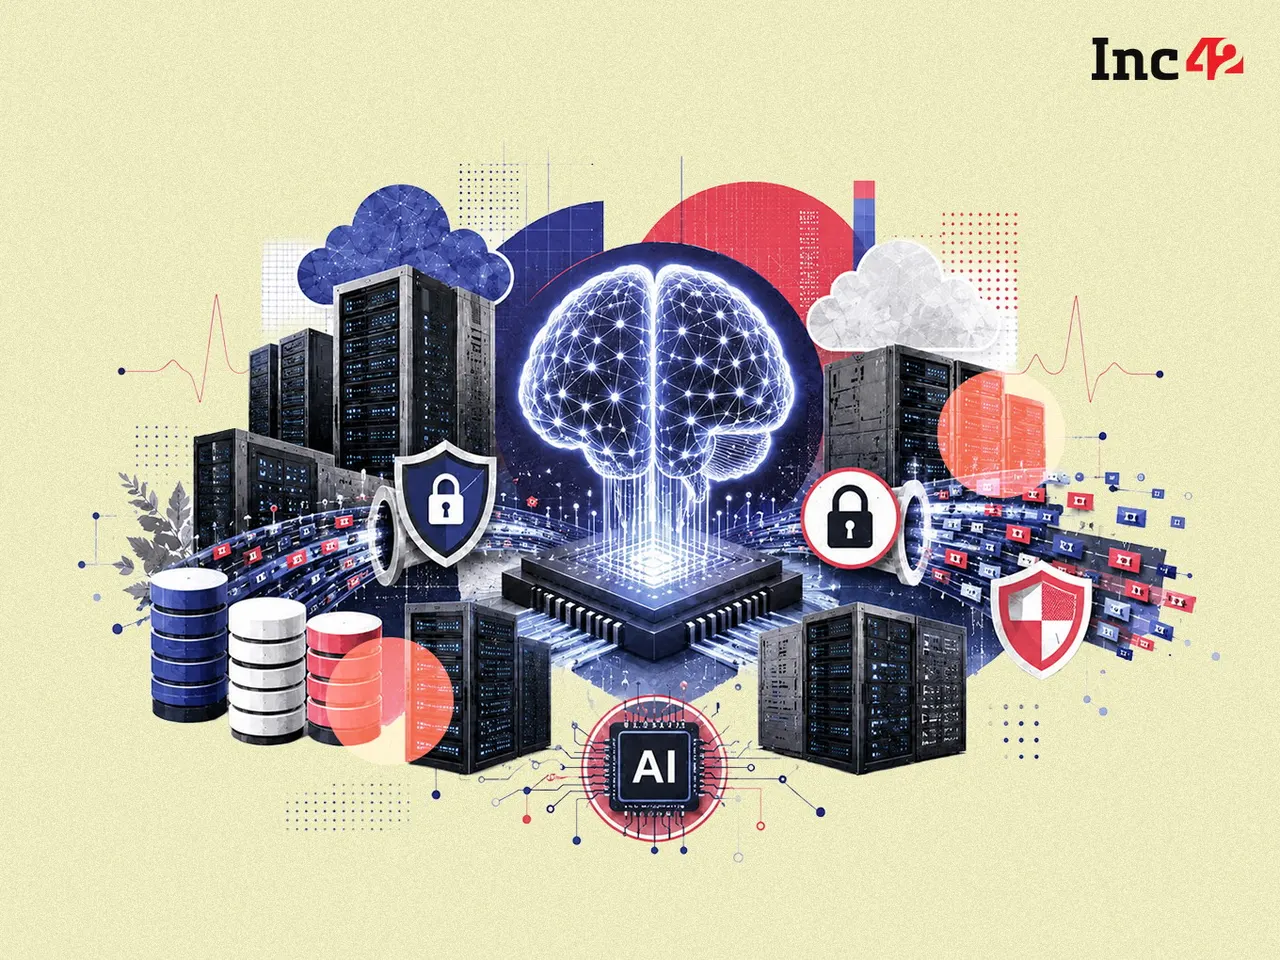
Indyjskie ministerstwo informatyki (MeitY) zaproponowało ramy wymiany danych opartej na zgodzie, które mają ułatwić trenowanie modeli sztucznej inteligencji w kraju. Rozwiązanie nosi nazwę Data Empowerment and Protection Architecture (DEPA) for AI training.
Celem jest umożliwienie startupom, firmom i instytucjom naukowym dostępu do dużych zbiorów danych specyficznych dla Indii przy jednoczesnej ochronie prywatności obywateli i zgodności z ustawą DPDP. Wytyczne powstały we współpracy z think tankiem iSPIRT. Architektura techniczno-prawna ma pozwalać organizacjom na wspólne trenowanie modeli bez bezpośredniego przekazywania zbiorów danych.
Cztery filary techniczne
DEPA dla AI opiera się na istniejącym systemie DEPA, który już obsługuje udostępnianie danych za zgodą, między innymi w ramach Account Aggregator. Nowe ramy obejmują cztery elementy: poufne „clean rooms”, czyli bezpieczne środowiska obliczeniowe, w których strony nie widzą swoich danych; prywatność różnicową, która uniemożliwia identyfikację pojedynczych osób w zbiorze zbiorczym; elektroniczne kontrakty, czyli czytelne maszynowo umowy określające dozwolone użycia i wymogi bezpieczeństwa; oraz model zero trust, w którym każde żądanie dostępu jest uwierzytelniane i autoryzowane.
Wyróżniono trzy grupy uczestników: dostawców danych treningowych (TDP), takich jak banki, szpitale i agencje rządowe; odbiorców (TDC), czyli startupy, przedsiębiorstwa, badaczy i osoby indywidualne; oraz pośredników zwanych Data Collectives lub Data Collabs, którzy agregują i standaryzują dane oraz ustalają zasady zarządzania nimi.
Jak to ma działać
Dostawcy rejestrują zanonimizowane i zaszyfrowane zbiory na platformie wymiany, oznaczone metadanymi i identyfikatorami kryptograficznymi. Odbiorca składa wniosek o zbiór do konkretnego zastosowania, a system kontraktów elektronicznych sprawdza go pod kątem polityk. Trening odbywa się w bezpiecznym środowisku z użyciem prywatności różnicowej, więc surowe dane pozostają niedostępne.
Wytrenowane modele mają przechodzić niezależne kontrole pod kątem stronniczości, uczciwości, bezpieczeństwa i wyjaśnialności; tylko zatwierdzone trafią do pilotażowych wdrożeń i skalowania. Nadzór ma trwać także po wdrożeniu: ciągły monitoring, okresowe przeglądy i możliwość powiązania wyników modelu z danymi i kontraktami.
Propozycja pojawia się wkrótce po projekcie wytycznych TRAI dotyczących odpowiedzialnego użycia AI w sieciach telekomunikacyjnych; konsultacje potrwają do 27 listopada. Minister Ashwini Vaishnaw zapowiadał też niedawno dokument konsultacyjny o bezpieczeństwie AI.
Więcej z tego dnia
Zobacz wszystkie →
ФНС testuje model scoringowy wykrywający ukryte dochody samozatrudnionych
Apple przejmuje Ascend.io w ramach acqui-hire dla narzędzi danych
Windows 11 Cloud Rebuild: reinstalacja z chmury bez rozruchu
Samsung z rekordowym zyskiem na pamięciach AI, a telefony na minusie
Więcej w kategorii: Startupy
Zobacz wszystkie →
Nüchtern: założycielka płakała w DHDL, dziś firma blisko zysku
Pine Labs: zysk netto w II kwartale wzrósł 6,5 raza do 38,6 mln rupii
OfBusiness przed IPO: Oxyzo generuje większość zysku segmentów