Revolut、全エンジニア2000人の標準AIにGLMを採用
Revolutは約2000人のエンジニアの標準コーディングAIをClaude CodeやCodexからオープンウェイトのGLMへ切り替え、AI費用は同等のフロンティアモデルの約10分の1になったという。
英フィンテック大手のRevolutは、中国Z.aiのAIモデル「GLM」を、約2000人のエンジニア向けの標準コーディングアシスタントにした。AI運用・インフラ責任者のDavid Abitbol氏によると、AnthropicやOpenAIのツールは、最も複雑な作業に限って残している。
Abitbol氏はベルリンで開かれたNvidiaのGTCで、同等のフロンティアモデルと比べて支払いが約10分の1になったと説明した。Revolutは世界で8000万人超の顧客を抱える。
切り替えの中身と成果
エンジニアはこれまでAnthropicのClaude CodeとOpenAIのCodexに頼っていたが、現在は主にオープンウェイトのGLMを使う。モデルはRevolut自社のサーバーで動かしている。フロンティアツールは小さな予算で、難問向けに使える状態だという。
同氏によれば、モデルの提供には約56基のNvidia GPUを使い、コストは100万トークンあたり約30セント。料金は固定で、リクエストごとに増えない。コーディング時間は約60%、課題の割り当てからデプロイまでのリードタイムは約70%短縮されたと述べた。
1月に導入したGoogleのGeminiでは、リードタイムが約10%、コーディング時間が約20%改善した。続くClaude Codeは月300ドルの予算だったが、月末まで持たず効果は小さかった。自社運用モデルではトークン無制限を掲げた結果、ConfluenceやJira、Slackの検索にも使われ、ボトルネックはコード作成より周辺業務にあると分かったという。
課題と中国製モデルへの懸念
導入は順調ではなかった。6月には毎秒4リクエストで応答が10秒を超えた。同じGPU数で調整した結果、毎秒8リクエスト超を1.8秒未満の遅延で処理できるようになった。コンテキストを25万6000トークンに制限し、FP8ではなくFP4を使えばGPU容量を約40%節約できるとも助言している。
中国製モデルへの懸念について、Abitbol氏はモデルの重みだけを使い、自社インフラかEU・米国の事業者で運用するため、データは中国のサービスに渡らないと強調した。エージェントはサンドボックス内で動き、人が常に関与する。GLMはテキスト専用のため、画像関連はGemini Flashなど安価なモデルに回している。
注目のアプリ
 SUMO:数字パズル
正しいマスを選んで足し算、目標の数に。覚えるのは簡単、極めるのは難しい。無料、全年齢向け。
 Dialo:話して学ぶ語学アプリ
AIの会話パートナーと話すだけ。一文ごとに添削され、あなたの言語で解説が返ってきます。9言語、A1からC2まで。
 ediviewer:EDIファイルを文書のように読む
EDIFACTやX12メッセージを開き、各セグメントの意味を表示。JSON/XML変換、PDF・Excel出力。ローカルで動作、アップロード不要。
 giftdetect:数分でぴったりの贈り物
相手、シーン、性格を選ぶだけ。検索エンジンが地元ショップの商品説明を読み、合うものを並べます。無料、登録不要。
同じ日のニュース
すべて見る →

関連カテゴリ: AI
すべて見る →
エルヴィス・プレスリー権利者、AnthropicをClaude訓練で提訴
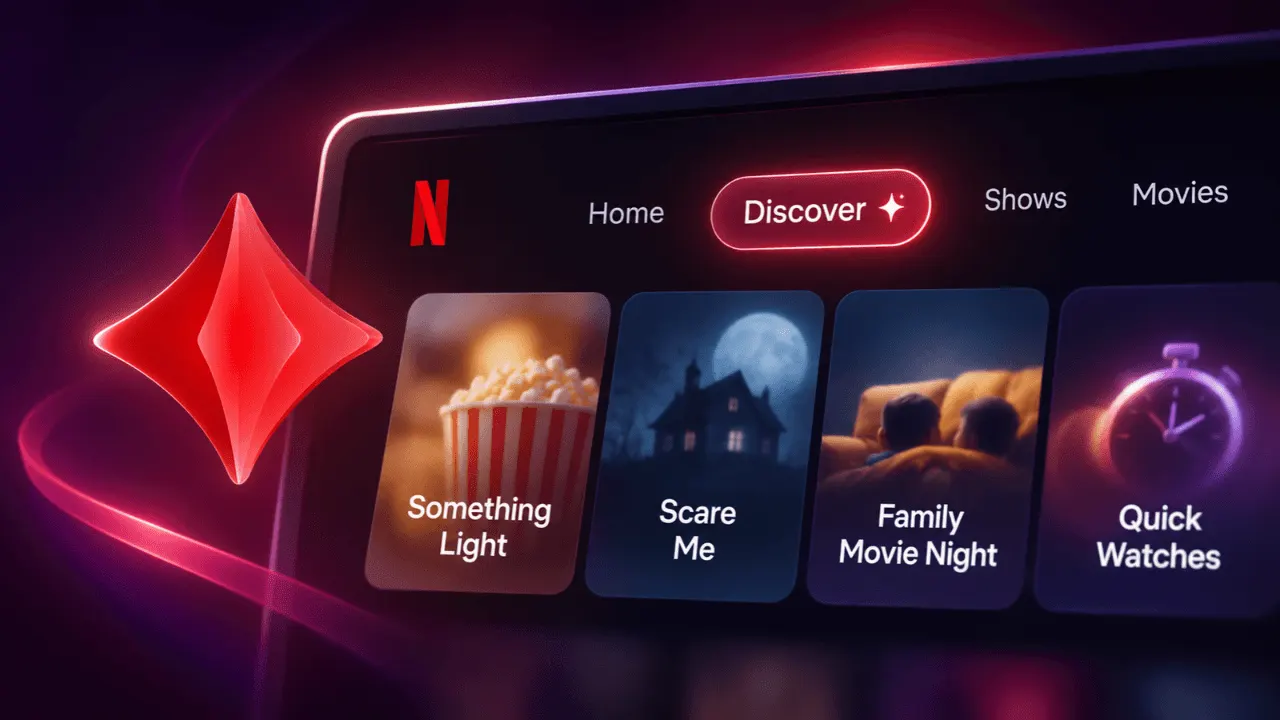
Netflix、AI活用の新タブ「AI Discover」を提供開始