Nvidia अध्ययन: संदर्भ का सारांश बनाने पर भी AI एजेंट का प्रदर्शन बरकरार
Nvidia के शोधकर्ताओं के मुताबिक लंबे काम के बीच बातचीत का सारांश बनाने से AI एजेंट का ज़्यादातर प्रदर्शन बना रहता है, जबकि लंबा संदर्भ चलाना कई गुना महंगा पड़ता है।
 SUMO· नंबर पज़ल
 Dialo· बोलकर भाषाएँ सीखें
 ediviewer· EDI फ़ाइलें दस्तावेज़ की तरह पढ़ें
 giftdetect· मिनटों में सही तोहफ़ा
Nvidia के 12 शोधकर्ताओं ने 3 नवंबर को arXiv पर एक पेपर जारी किया है। इसके अनुसार, लंबे काम के बीच बातचीत का सारांश बनाकर उसे छोटा कर देने पर भी AI एजेंट का ज़्यादातर प्रदर्शन बना रहा। यह उस आम धारणा के उलट है कि मॉडल जितना ज़्यादा संदर्भ याद रखे, नतीजे उतने बेहतर होते हैं। यहाँ संदर्भ (context) का मतलब उस बातचीत और सामग्री की मात्रा से है, जिसे मॉडल जवाब बनाते समय एक साथ देखता है।
लंबे संदर्भ की बढ़ती लागत
शोधकर्ताओं ने पाया कि संदर्भ जितना लंबा होता है, बाद में बनने वाले टोकन उतने ही महंगे पड़ते हैं। पेपर के अनुसार खुले वेट वाले नए मॉडलों में यह फ़र्क़ 7 गुना तक पहुँच सकता है। 256K संदर्भ पर प्रति टोकन लागत 16K की तुलना में Z.ai के GLM 5.2 में 3.6 गुना, Moonshot AI के Kimi K2.6 में 5.6 गुना और Alibaba के Qwen3 Coder Next में 7 गुना रही।
सारांश वाली पद्धति के नतीजे
टीम ने ऐसी पद्धति आज़माई जिसमें बातचीत तय लंबाई पर पहुँचते ही अब तक की सामग्री का सारांश बना दिया जाता है और काम आगे बढ़ता है। परीक्षण SWE-bench Verified, Terminal-Bench 2.1, FRAMES और BFCLv3 जैसे छह लंबे कार्यों पर हुए, जिनमें मुख्यतः Anthropic के Claude Opus 4.5 और OpenAI के GPT 5.6 Sol का इस्तेमाल हुआ। संदर्भ की कुल सीमा और सारांश शुरू करने की लंबाई बदलकर बनाई गई 22 सेटिंग में से केवल 5 या उससे कम में स्कोर बेसलाइन से 2 अंक से ज़्यादा गिरा।
LOONG के 1,600 प्रश्नों में Claude Opus 4.5 को पूरी सामग्री देने पर औसत स्कोर 70.1 और पूरी तरह सही उत्तर 38.9% रहे। जब केवल ज़रूरी हिस्से चुनकर पढ़े और सारांशित किए गए और संदर्भ 16,000 टोकन से नीचे रखा गया, तो औसत स्कोर 79.3 और पूरी तरह सही उत्तर 53.4% हो गए।
सीमाएँ
यह तरीक़ा हर मॉडल पर कारगर नहीं रहा। परिशिष्ट के मुताबिक Qwen3 Coder Next में 16K सेटिंग पर कोडिंग समस्या हल करने की सफलता दर 53.0% से गिरकर 3.6% रह गई, जिसे पेपर ने "catastrophically collapses" कहा है। शोधकर्ताओं ने आगे "Semantic State Space Model" का विचार भी रखा है, पर इसे न प्रशिक्षित किया गया और न परखा गया। पेपर का निष्कर्ष है कि ये नतीजे लंबे संदर्भ वाले भाषा मॉडलों की ज़रूरत पर सवाल उठाते हैं।
देखने लायक ऐप्स
SUMO: नंबर पज़लसही खाने चुनें, जोड़ें, लक्ष्य तक पहुँचें। सीखना आसान, महारत मुश्किल। मुफ़्त, हर उम्र के लिए।
Dialo: बोलकर भाषाएँ सीखेंAI बातचीत साथी से बात करें; हर वाक्य सुधरकर आपकी भाषा में समझाया हुआ लौटता है। 9 भाषाएँ, A1 से C2 तक।
ediviewer: EDI फ़ाइलें दस्तावेज़ की तरह पढ़ेंEDIFACT और X12 संदेश खोलें, हर सेगमेंट की व्याख्या देखें, JSON/XML में बदलें, PDF और Excel में निर्यात करें। स्थानीय रूप से चलता है, कोई अपलोड नहीं।
giftdetect: मिनटों में सही तोहफ़ाचुनें किसके लिए, किस मौके पर और कैसा स्वभाव। सर्च इंजन स्थानीय दुकानों के उत्पाद विवरण पढ़कर सबसे उपयुक्त विकल्प ऊपर रखता है। मुफ़्त, बिना साइन-अप।
इसी दिन की और ख़बरें
सभी देखें →
फ्रांस ने Airbus और Thales से मंगवाए IRIS जासूसी सैटेलाइट
फ्रांस ने सुपरमार्केट फ्रिज हैक के लिए ईरान की Shahid Kaveh को ठहराया दोषी
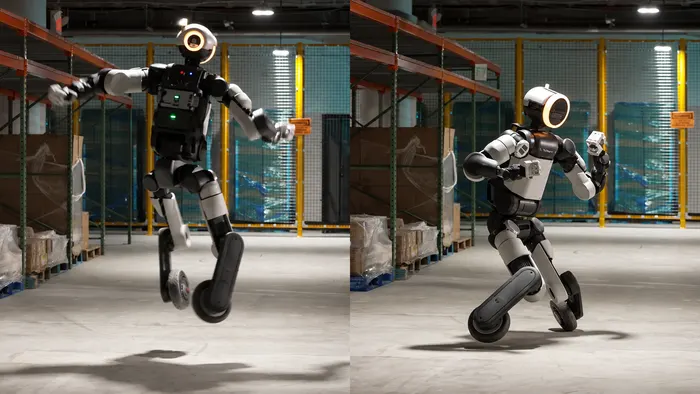
Boston Dynamics के Atlas के पैरों में लगे पहिए, 360 डिग्री जंप भी