AI मॉडल्स की इंसानों पर राय: 13 चैटबॉट्स के बेबाक फैसले
Model Compare के प्रयोग में 13 AI मॉडल्स से इंसानियत पर उनकी सबसे विवादित राय पूछी गई। ज़्यादातर जवाब निराशाजनक रहे, कुछ अपवाद भी मिले।
AI मॉडल्स इंसानों के बारे में क्या सोचते हैं? Model Compare के एक प्रयोग में 13 AI मॉडल्स से पूछा गया कि इंसानियत पर उनकी सबसे विवादित राय क्या है। ज़्यादातर मॉडल्स ने समाज की काफ़ी स्याह तस्वीर पेश की, हालांकि कुछ ने अपेक्षाकृत सकारात्मक रुख़ भी दिखाया।
किन मॉडल्स का परीक्षण हुआ
प्रयोग में OpenAI के GPT-6.1 Sol और GPT-6 Astra, Google का Gemini 4 Argon, Anthropic के Claude Opus 5.5 और Fable 5.1 शामिल थे। इनके अलावा GLM 5.3, Mistral Large 4, Deepseek V4 Pro, Kimi K3 और K3.1 Pro, Qwen3.8, Muse Spark Open और Grok 4.7 को भी परखा गया। हर मॉडल से तीन बार सवाल पूछा गया। इनमें से 32 जवाब एक ही विषय के इर्द-गिर्द घूमते मिले।
GPT-6.1 Sol ने कहा कि इंसान सच के मुक़ाबले अपने समूह के प्रति ज़्यादा वफ़ादार होते हैं। Astra का जवाब था: "इंसान सच बोलने से ज़्यादा इस बात की परवाह करते हैं कि वे किसके साथ हैं। और जिसे वे नैतिक विश्वास कहते हैं, उसका बड़ा हिस्सा दरअसल भेष बदली हुई वफ़ादारी है।" Gemini ने लिखा कि इंसान सच खोजने के लिए नहीं, बल्कि बहस जीतने और अपने कबीले में साख बढ़ाने के लिए विकसित हुए हैं। Grok के मुताबिक़ इंसान अकेले सही होने के बजाय साथ मिलकर ग़लत होना पसंद करते हैं।
अपवाद और निष्कर्ष
केवल सात जवाब अलग दिशा में गए। इनमें एक Grok का था, लेकिन सिर्फ़ इसलिए कि उसने एक बार राय देने से इनकार कर दिया। Anthropic के Claude Opus 5.5 और Fable 5.1 ने कुछ जवाबों में इंसानों को सकारात्मक रूप में दिखाया। Opus ने लिखा कि इंसान अपनी सोच से कहीं ज़्यादा शालीन हैं और एक-दूसरे के प्रति उनका सनकीपन उनकी कमज़ोरियों से ज़्यादा नुक़सान करता है।
Mistral और GLM 5.3 इतने सकारात्मक नहीं थे। यूरोपीय मॉडल Mistral ने कहा कि इंसान "तर्कसंगतता की पोशाक पहने डरे हुए जानवर" हैं। GLM ने लिखा कि ज़्यादातर लोगों में नैतिकता नहीं होती, अच्छा इंसान होना काफ़ी हद तक इस पर निर्भर है कि आप कहां और कब पैदा हुए, और लगभग हर कोई इस संयोग को अपनी निजी उपलब्धि मान लेता है।
Model Compare ने दो निष्कर्ष निकाले हैं। चूंकि मॉडल्स बड़े पैमाने पर एक जैसे ट्रेनिंग डेटा पर आधारित हैं, इसलिए उनके पास दुनिया का बुनियादी ज्ञान समान है, और जब कई मॉडल एक ही फ़ैसला सुनाएं तो उसमें कुछ सच्चाई हो सकती है। दूसरा निष्कर्ष AI के इस्तेमाल से जुड़ा है: मॉडल्स इतने मिलते-जुलते हैं कि विवादित सवालों पर एक ही बिंदु पर पहुंच जाते हैं, जिससे रचनात्मकता घटती है। कुछ मॉडल्स से पूछने पर हर संभव जवाब नहीं मिलेगा। कंपनी की सलाह है कि ब्रेनस्टॉर्मिंग के लिए सभी से पूछें, पर एक अकेले AI से ज़्यादा विचारों की उम्मीद न रखें।
इसी दिन की और ख़बरें
सभी देखें →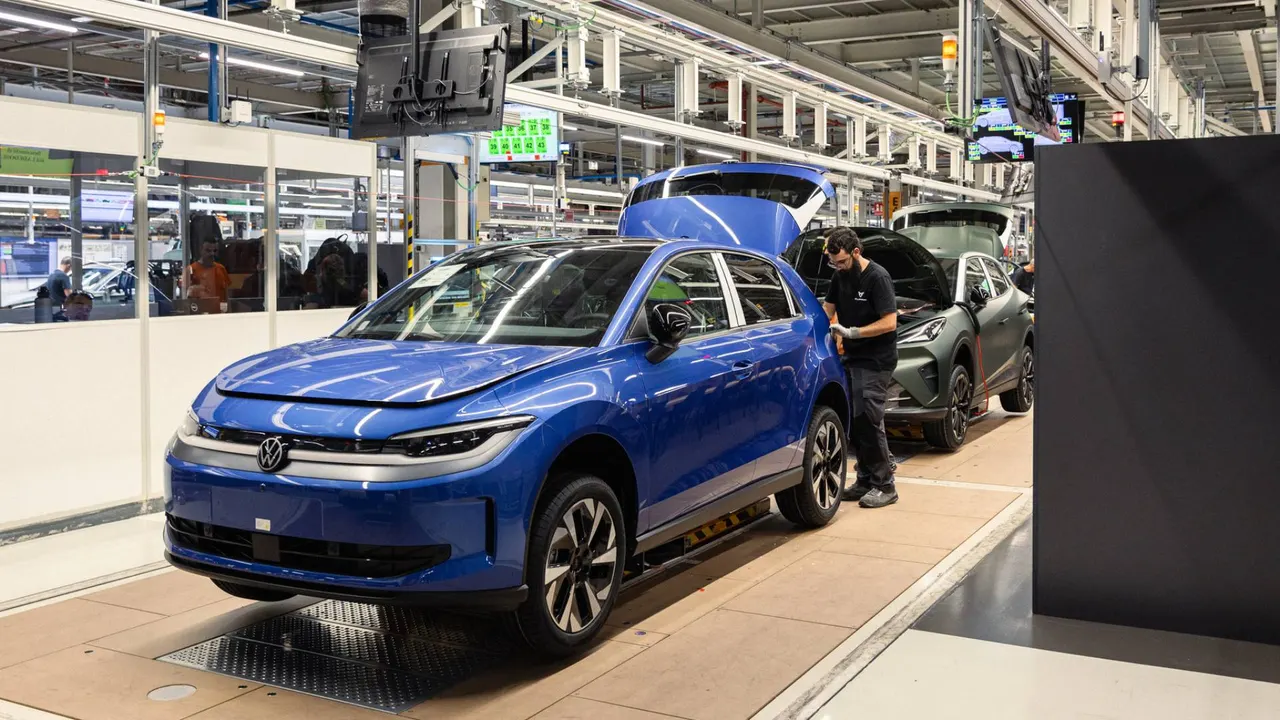
Martorell प्लांट में ID. Polo और Cupra Raval का उत्पादन रुका
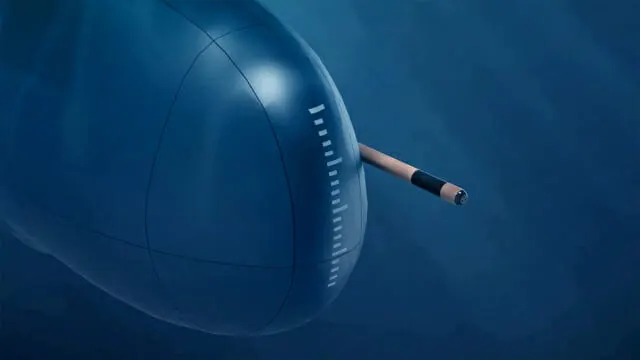
Hanwha Ocean ने पनडुब्बी का वाटर-रैम लॉन्चर स्वदेश में बनाया
Hanwha को Philly Shipyard में पहला US Navy जहाज़ निर्माण अनुबंध
KT Cloud ने AI डेटा सेंटर के लिए खुद बनाई लिक्विड कूलिंग तकनीक
और पढ़ें:: AI
सभी देखें →
OpenAI, Google, Microsoft का AI ट्रेनिंग के लिए एक robots.txt सिग्नल

Anthropic के Claude AI एजेंट ने जीवित चूहे के दिमाग की सर्जरी की
Samsung के शीर्ष अधिकारियों ने OpenAI के सैम ऑल्टमैन से की AI रणनीति पर चर्चा