robots.txt para IA: Google, OpenAI y Microsoft crean un estándar
OpenAI, Google, Microsoft y Anthropic desarrollan una especificación común para que los sitios web permitan o rechacen el entrenamiento de IA mediante robots.txt.
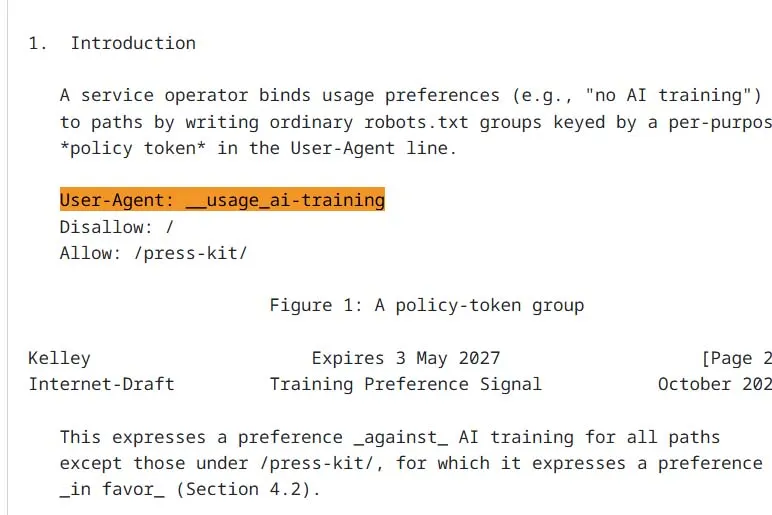
OpenAI, Google, Microsoft y Anthropic han anunciado el desarrollo de una especificación común que permitirá a los administradores de sitios web indicar en robots.txt si su contenido puede usarse para entrenar sistemas de IA. Prevén introducirla en 2027.
El archivo robots.txt informa a los rastreadores, programas que recopilan información de forma automática, de a qué páginas pueden acceder. Así, los responsables de un sitio pueden permitir o bloquear servicios de búsqueda y de IA. Sin embargo, los servicios de IA suelen ignorar el archivo, un problema que en Japón ha señalado, entre otros, la asociación de periódicos.
Una señal común en lugar de muchas reglas
Hasta ahora, los administradores debían identificar cada rastreador por separado y gestionar normas distintas para cada empresa. La nueva iniciativa busca reducir esa carga mediante una señal compartida por toda la industria.
Según Google, los propietarios de sitios podrán usar en robots.txt un «token de política» común que se aplique a todos los proveedores de IA participantes. Google menciona como ejemplo su mecanismo actual Google-Extended: permite a un editor mantener el rastreo para la búsqueda y a la vez rechazar el entrenamiento de Gemini. El objetivo es convertir ese tipo de ajuste en un mecanismo común de robots.txt.
La especificación se debatirá y redactará en el grupo de trabajo «AI Preferences» de la Internet Engineering Task Force (IETF).
Plazos y controles propios
Google prevé adoptarla en 2027. OpenAI aspira a hacerlo en los próximos meses, y Microsoft la aplicará desde febrero de 2027.
Las compañías mantendrán sus propios controles de rastreo junto al estándar. En Google, los ajustes más detallados seguirán gestionándose con Google-Extended, mientras que Microsoft añadirá configuraciones de entrenamiento por página y un ajuste independiente de grounding.
Para los editores, una única instrucción podría simplificar la gestión. La clave será si los rastreadores la respetan de verdad.
Más de este día
Ver todas →
Amazon Echo Time, Dot y Studio: tres nuevos dispositivos con Alexa Plus
Google paraliza obras en Finlandia tras talar 250.000 árboles ilegalmente
Apple: John Ternus resta importancia a su retraso en IA