Nvidia-Studie: Zusammenfassen hält KI-Agenten leistungsfähig
Nvidia-Forscher zeigen: Fasst man den Gesprächsverlauf zwischendurch zusammen, behalten KI-Agenten meist ihre Leistung. Lange Kontextfenster werden infrage gestellt.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
KI-Agenten behalten den Großteil ihrer Leistung, wenn man den Gesprächsverlauf mitten in einer Aufgabe zusammenfasst und verkürzt. Das berichten zwölf Nvidia-Forscher in einem Paper, das am 3. November auf arXiv erschienen ist. Die Arbeit stellt die verbreitete Annahme infrage, längerer Kontext sei automatisch besser.
Mit Kontext ist die Menge an Gespräch und Material gemeint, die ein Modell bei einer Antwort gleichzeitig berücksichtigt. Laut den Autoren wird jedes später erzeugte Token teurer, je länger der Kontext ist. Bei aktuellen Open-Weight-Modellen kann der Unterschied laut Abstract bis zum Siebenfachen betragen. Bei 256K statt 16K Kontext kostete ein generiertes Token bei GLM 5.2 von Z.ai das 3,6-Fache, bei Kimi K2.6 von Moonshot AI das 5,6-Fache und bei Qwen3 Coder Next von Alibaba das 7-Fache.
Was die Tests ergaben
Die Forscher ließen Agenten ihren Verlauf ab einer bestimmten Länge zusammenfassen und dann weiterarbeiten. Eingesetzt wurden vor allem Claude Opus 4.5 von Anthropic und GPT 5.6 Sol von OpenAI, getestet auf sechs Langzeit-Benchmarks, darunter SWE-bench Verified, Terminal-Bench 2.1, FRAMES und BFCLv3. Bei 22 Einstellungen mit variierendem Kontextlimit und Zusammenfassungsschwelle lagen höchstens fünf mehr als 2 Punkte unter dem Referenzwert.
Im Setup mit einer Aktion pro Runde und nur komprimiertem Aufgabenstand erreichte Claude Opus 4.5 bei SWE-bench Verified 70,2 statt 70,0 Punkte, GPT 5.6 Sol fiel von 84,4 auf 82,4. Beim LOONG-Benchmark mit 1.600 Fragen kam Claude Opus 4.5 mit allen Dokumenten auf durchschnittlich 70,1 Punkte und 38,9 % vollständig richtige Antworten. Mit gezielter Auswahl und Zusammenfassung unter 16.000 Token waren es 79,3 Punkte und 53,4 %.
Einschränkungen
Nicht jedes Modell profitiert. Im Anhang brach Qwen3 Coder Next mit Zusammenfassung bei 16K von 53,0 % auf 3,6 % Erfolgsquote bei SWE-bench ein; das Paper spricht von einem katastrophalen Zusammenbruch.
Vorgeschlagen wird zudem ein „Semantic State Space Model“, das einen in natürlicher Sprache beschriebenen Aufgabenstand liest, handelt und ihn neu schreibt. Es bleibt ein Konzept und wurde weder trainiert noch evaluiert. Laut Abstract stellen die Ergebnisse die Notwendigkeit von Langkontext-Sprachmodellen infrage.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Frankreich bestellt IRIS: neue Spionagesatelliten von Airbus
Kühlhaus-Hack in Frankreich: Paris beschuldigt Irans Shahid Kaveh
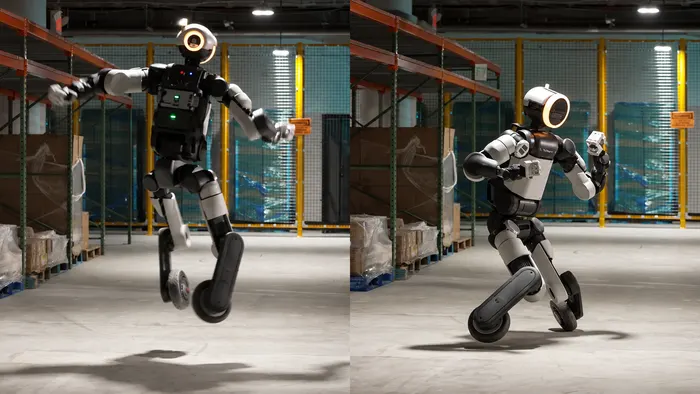
Boston Dynamics: Atlas mit Rädern schafft 360-Grad-Sprung

Südkoreas Finanzsicherheitsinstitut gehackt: Prüfunterlagen abgeflossen
Mehr aus: KI
Alle anzeigen →
REA: KI-Tool macht Reverse Engineering von Smart-TVs zum Trend
Meta Muse Ember: Kleinstes KI-Modell kostet 0,10 Dollar pro Million Tokens
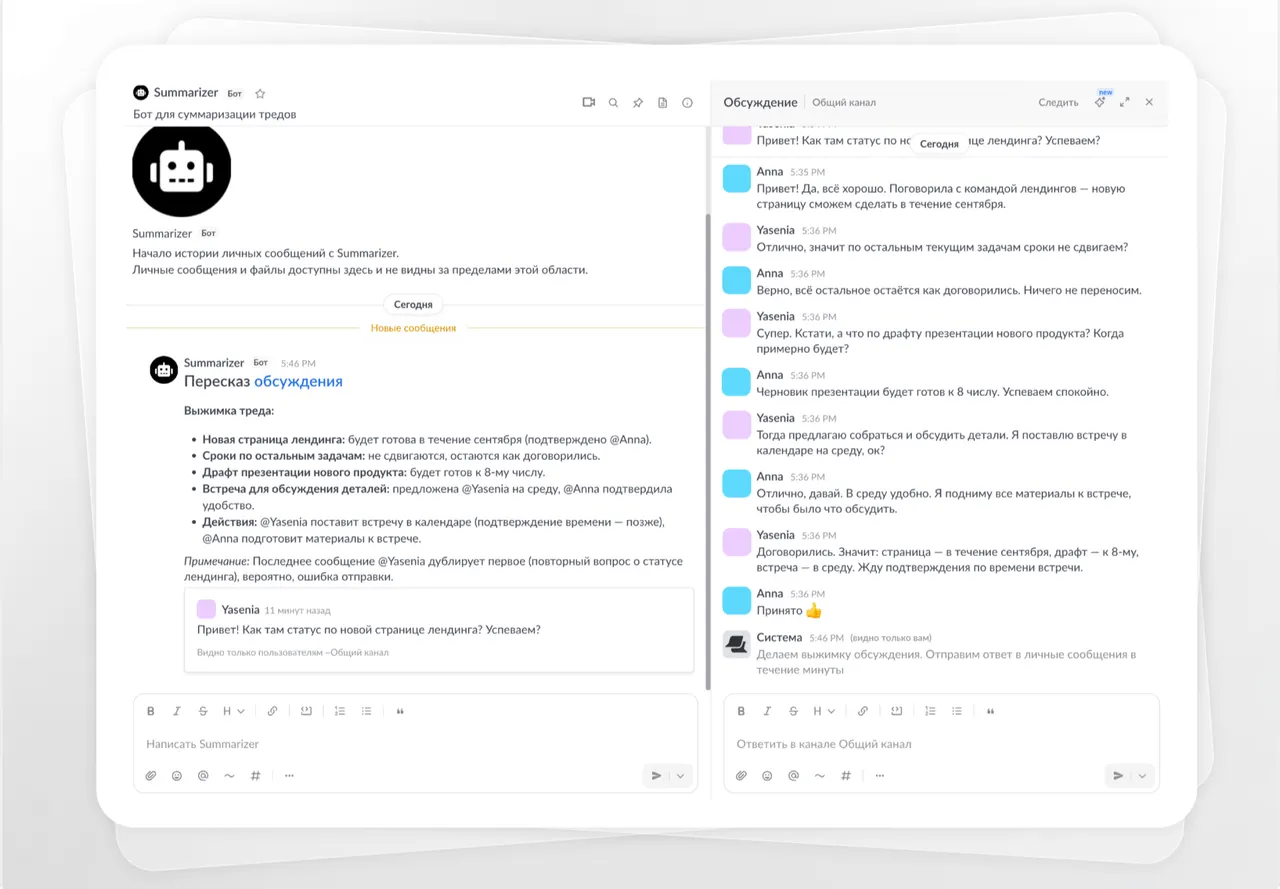
T-Bank: Messenger Time erhält KI-Assistent und MCP-Server