Yapay zeka insanlık hakkında ne düşünüyor? 13 model yanıtladı
Model Compare deneyinde 13 yapay zeka modeline insanlık hakkındaki en tartışmalı görüşleri soruldu. Yanıtların çoğu karamsar çıktı, birkaç istisna ise daha olumluydu.
Yapay zeka modelleri insanlık hakkında pek de parlak bir tablo çizmiyor. Model Compare'in yaptığı bir deneyde 13 modele insanlık hakkındaki en tartışmalı görüşleri soruldu. Yanıtların büyük bölümü eleştirel oldu, yalnızca birkaç model daha olumlu bir bakış sundu.
Hangi modeller test edildi
Deneyde OpenAI'dan GPT-6.1 Sol ve GPT-6 Astra, Google'dan Gemini 4 Argon, Anthropic'ten Claude Opus 5.5 ve Fable 5.1 yer aldı. Bunlara GLM 5.3, Mistral Large 4, Deepseek V4 Pro, Kimi K3 ve K3.1 Pro, Qwen3.8, Muse Spark Open ve Grok 4.7 eklendi. Her modele üç kez soru yöneltildi. Yanıtların 32'si aynı temaya odaklandı: insanlar gerçeğe değil, ait oldukları gruba bağlı.
GPT-6.1 Sol, insanların gerçeğe olduğundan daha sadık olduğunu söyledi; yani aidiyete daha bağlı olduklarını belirtti. Astra ise insanların gerçeği söylemekten çok aidiyetleriyle ilgilendiğini, ahlaki inanç dedikleri şeyin çoğunun aslında kılık değiştirmiş sadakat olduğunu savundu. Gemini, insanların gerçeği bulmak için değil, tartışmaları kazanmak ve kabilesinin gözünde yükselmek için evrimleştiğini yazdı. Grok ise insanların tek başına haklı olmaktansa birlikte yanılmayı tercih edeceğini ekledi.
İstisnalar ve çıkarılan dersler
Yalnızca yedi yanıt farklı yönde ilerledi. Bunlardan biri Grok'a ait, ancak model bir denemede görüş bildirmeyi reddettiği için. Anthropic'in Claude Opus 5.5 ve Fable 5.1 modelleri ise insanları kısmen olumlu gösterdi. Opus, insanların sandıklarından çok daha dürüst olduğunu, birbirlerine yönelik alaycılığın gerçek zayıflıklarından daha fazla zarar verdiğini yazdı.
Avrupa'nın Mistral modeli ile GLM 5.3 ise o kadar iyimser değildi. Mistral insanları „rasyonellik kostümü giymiş korkmuş hayvanlar” diye niteledi. GLM, çoğu insanın ahlakı olmadığını, iyi biri olmanın büyük ölçüde nerede ve ne zaman doğduğunuza bağlı bir şans meselesi olduğunu, yine de herkesin bu tesadüfü kişisel başarı sandığını belirtti.
Deneyin arkasındaki ekip iki sonuç çıkarıyor. Modeller büyük ölçüde aynı eğitim verilerine dayandığı için ortak bir yargıda bir miktar doğruluk payı olabilir. İkinci sonuç yapay zekâ kullanımıyla ilgili: modeller birbirine benzediği için tartışmalı sorularda aynı noktada buluşuyor ve bu yaratıcılığı azaltıyor. Model Compare, beyin fırtınası için hepsine sormayı öneriyor ancak tek bir yapay zekâdan fazla fikir beklememek gerektiğini vurguluyor.
Aynı günden diğer haberler
Tümünü gör →
Google Suncatcher uydusu yörüngede yapay zekâ çalıştırıp haiku yazdı
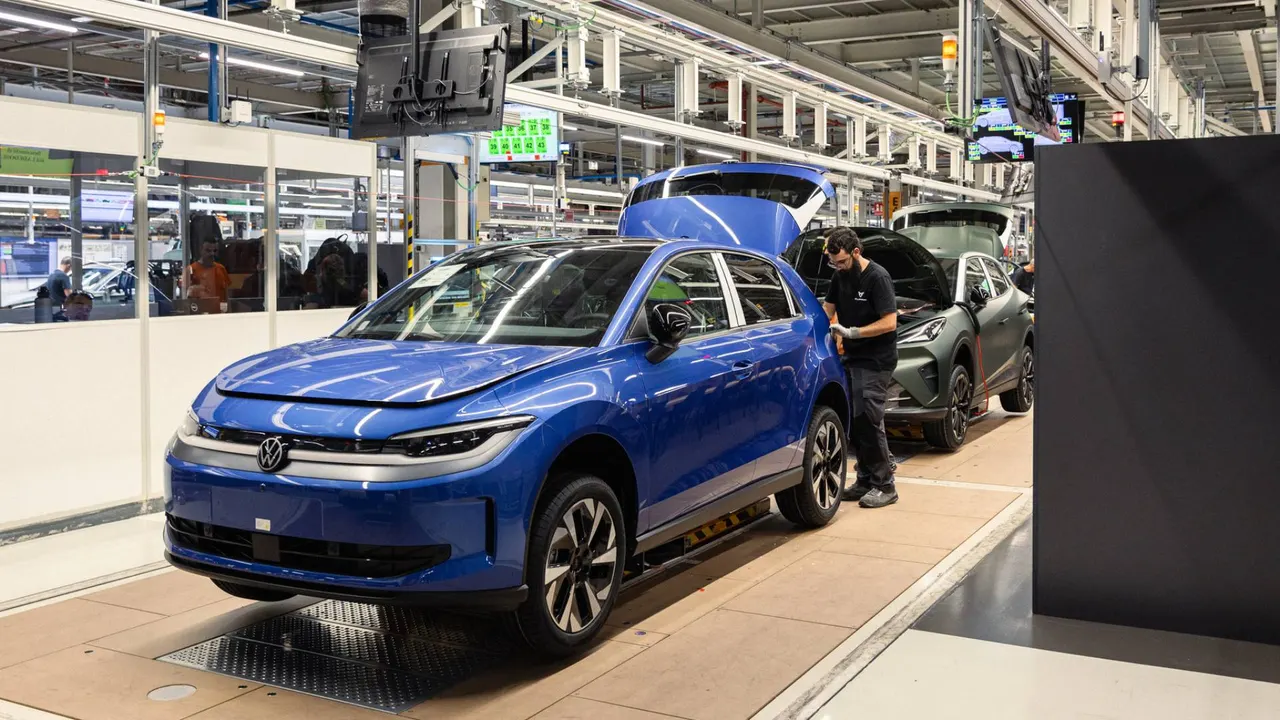
Martorell, hücre eksikliği nedeniyle ID. Polo ve Raval üretimini durdurdu
Hanwha Ocean, denizaltılar için yerli water-ram fırlatıcı geliştirdi
Hanwha, Philly Shipyard ile ilk ABD Deniz Kuvvetleri gemisi sözleşmesini aldı
Daha fazla: Yapay zekâ
Tümünü gör →
OpenAI, Google ve Microsoft ortak robots.txt sinyalini destekleyecek

Anthropic Claude yapay zeka ajanı canlı farenin beynini ameliyat etti
Samsung yöneticileri OpenAI CEO'su Sam Altman ile AI'yı konuştu