Nvidia: суммаризация контекста сохраняет качество ИИ-агентов
Исследователи Nvidia показали, что периодическое сжатие диалога в краткое резюме сохраняет большую часть качества ИИ-агентов и может снизить расходы.
 SUMO· числовая головоломка
 Dialo· учите языки, разговаривая
 ediviewer· читайте EDI-файлы как документы
 giftdetect· подходящий подарок за минуты
Чем длиннее контекст, тем лучше работает модель — это представление оспорили исследователи Nvidia. Двенадцать авторов 3 ноября опубликовали на arXiv статью, согласно которой сжатие диалога в резюме посреди длинной задачи сохраняет большую часть производительности ИИ-агентов. Контекстом называют объём диалога и материалов, которые модель учитывает одновременно при формировании ответа.
Длинный контекст дорожает
Учёные установили, что при росте контекста более поздние токены обходятся дороже ранних. Как следует из аннотации, у современных моделей с открытыми весами разница может достигать 7 раз. При работе с контекстом 256K стоимость одного сгенерированного токена выше, чем при 16K, в 3,6 раза у GLM 5.2 от Z.ai, в 5,6 раза у Kimi K2.6 от Moonshot AI и в 7 раз у Qwen3 Coder Next от Alibaba.
Что показали тесты
Команда проверила подход, при котором по достижении заданной длины диалог резюмируется, и работа продолжается. На шести длинных тестах, включая SWE-bench Verified, Terminal-Bench 2.1, FRAMES и BFCLv3, использовались главным образом Claude Opus 4.5 и GPT 5.6 Sol. Из 22 конфигураций с разным лимитом контекста и порогом начала суммаризации не более пяти показали падение больше чем на 2 балла относительно базового уровня. Когда на каждый диалог выполнялось одно действие и дальше передавалось лишь сжатое состояние задачи, Claude Opus 4.5 в тесте на решение программных задач получил 70,2 балла против 70,0, а GPT 5.6 Sol — 82,4 против 84,4.
На тесте LOONG из 1600 вопросов по нескольким длинным документам Claude Opus 4.5 с полным набором материалов набрал в среднем 70,1 балла и 38,9% полностью верных ответов. Когда модель выбирала нужные фрагменты, резюмировала их и держала контекст в пределах 16 тысяч токенов, результат вырос до 79,3 балла и 53,4%.
Подход работает не для всех моделей. В приложении указано, что Qwen3 Coder Next при суммаризации в режиме 16K показала падение успешности в программных задачах с 53,0% до 3,6%; авторы называют это «катастрофическим обвалом».
Кроме того, исследователи предложили «Semantic State Space Model» — модель, дообученную читать описание состояния задачи на естественном языке, действовать и переписывать это описание. Пока это лишь концепция: её не обучали и не оценивали. По словам авторов, результаты ставят под сомнение необходимость языковых моделей с длинным контекстом. Для компаний, использующих ИИ-агентов, это значит, что на стоимость и качество может влиять не длина контекста, а то, что в нём остаётся.
Приложения, на которые стоит взглянуть
SUMO: числовая головоломкаВыбирайте нужные клетки, складывайте, достигайте цели. Легко понять, сложно освоить. Бесплатно, для любого возраста.
Dialo: учите языки, разговариваяОбщайтесь с ИИ-собеседником: каждая фраза возвращается исправленной и объяснённой на вашем языке. 9 языков, от A1 до C2.
ediviewer: читайте EDI-файлы как документыОткрывайте сообщения EDIFACT и X12, каждый сегмент объяснён, конвертация в JSON/XML, экспорт в PDF и Excel. Работает локально, без загрузки.
giftdetect: подходящий подарок за минутыВыберите, кому, по какому поводу и с каким характером. Поисковик читает описания товаров местных магазинов и выводит то, что подходит. Бесплатно, без регистрации.
Ещё за этот день
Показать все →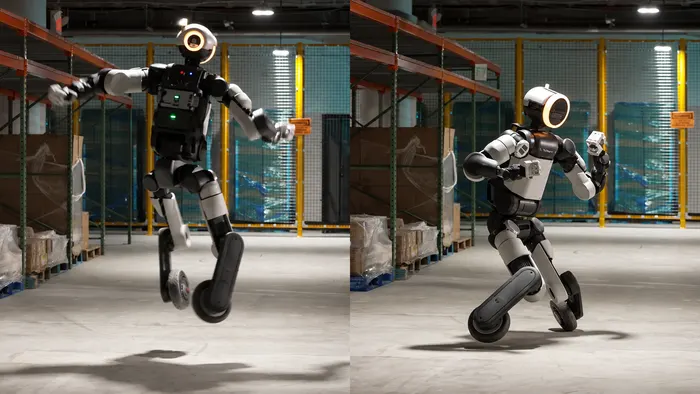
Boston Dynamics поставила Atlas на колёса и показала прыжок на 360°

Корейский институт финансовой безопасности взломан, данные утекли
REA: ИИ-агенты переписывают ПО смарт-ТВ и приложений
Sharefull: возможная утечка данных до 7,5 млн аккаунтов сервиса подработок
Ещё в рубрике: ИИ
Показать все →
Meta представила Muse Ember — самую малую ИИ-модель за $0,10
«Т-Банк» добавил в мессенджер Time ИИ-помощника и MCP-сервер