AI 리서치 보고서의 함정, AI가 AI를 검증하자 생긴 일
제품 마케팅 리드가 아이디어를 검증하는 에이전트 시스템을 만들었더니 AI의 오류가 더 교묘해졌습니다. 대표적인 여섯 가지 사례입니다.
링크는 가짜인데 결론은 그대로입니다. Deloitte 사건을 요약하면 이렇습니다. 이 회사는 존재하지 않는 출처가 담긴 보고서를 호주 정부에 제출했고, 마지막 대금 반환에는 동의했습니다. 하지만 해당 부처는 권고 사항이 바뀌지 않았다고 밝혔습니다. 지난 1년간 캐나다와 호주의 Deloitte, EY, KPMG 보고서에서도 없는 출처와 잘못된 링크가 나왔습니다.
제품 마케팅 팀을 이끄는 글쓴이는 AI의 도움을 받으려고 «Полигон гипотез»(가설 연습장)라는 시스템을 만들었습니다. 아이디어와 맥락을 주면 에이전트들이 검증 가능한 주장으로 쪼개고, 근거와 모순을 찾아 버릴 것과 다듬을 것을 제안합니다. 필요하면 추가 자료를 모으고 합성 실험도 합니다.
문제는 오류가 정교해졌다는 점입니다. 출처는 진짜이고 인용도 글자 그대로 맞지만 그로부터 끌어낸 결론이 틀립니다. 규칙을 엄격하게 하자 시스템은 신중해졌지만 쓸모도 줄었다고 합니다.
AI 리서치 보고서에서 흔한 여섯 가지 오류는?
글쓴이가 직접 겪은 사례입니다.
- 과잉 일반화. «대부분의 고객이 불만»이지만 실제로는 열 명 중 두 명이었고 나머지는 연동 기능을 써 보지 않았습니다.
- 원하는 결론을 전제로 삼기. 네 명의 «있으면 좋겠다»가 «수요 확인»이 됐습니다. 여섯 명은 언급하지 않았고, 브리프에는 이미 «앱이 필요하다»고 적혀 있었습니다.
- 같은 출처의 메아리. «연 25% 성장»을 세 기관이 확인했지만 모두 한 제조사의 보도자료를 옮긴 것이었습니다.
- 질문 이탈. 구독을 왜 갱신하지 않느냐는 질문에 첫 구매 분석으로 답했습니다.
- 검색 범위 은폐. 영어로 두 번 검색하고 «경쟁자 없음»이라 결론 냈지만 현지 기업이 그 기능을 팔고 있었습니다.
- 지어낸 이야기. «대형 은행 이탈률 15% 감소»는 자료에 근거가 없었습니다.
글쓴이는 어떻게 바꿨나
일반화에는 누가 무엇을 말했는지 목록을 요구합니다. 스크립트가 인원을 세고, 다른 에이전트가 한 집단으로 묶어도 되는지 확인합니다. 브리프의 주장도 검증 대상에 넣고, 핵심 결론마다 가장 강한 반론을 붙이게 했습니다. 근거는 출처 대장으로 셉니다.
검색에서는 반증을 찾고, 어디를 찾았고 무엇을 확인하지 않았는지 기록하게 합니다. 사실 주장에는 출처가 필수입니다. 인용은 스크립트가 원문에서 찾고, 계산은 수식으로 다시 하며, 별도 에이전트가 그 대목이 결론을 뒷받침하는지 봅니다.
글쓴이의 말로는 AI가 싸게 만든 것은 생성이지 검증이 아닙니다.
주목할 만한 앱
 SUMO: 숫자 퍼즐
올바른 칸을 고르고 더해 목표 숫자를 맞추세요. 배우긴 쉽고 마스터하긴 어렵습니다. 무료, 전 연령.
 Dialo: 말하면서 배우는 언어 앱
AI 대화 파트너와 대화하세요. 모든 문장이 교정되어 내 언어로 설명과 함께 돌아옵니다. 9개 언어, A1부터 C2까지.
 ediviewer: EDI 파일을 문서처럼 읽기
EDIFACT와 X12 메시지를 열어 각 세그먼트 설명을 보고, JSON/XML로 변환하고, PDF와 Excel로 내보내세요. 로컬에서 실행, 업로드 없음.
 giftdetect: 몇 분 만에 딱 맞는 선물
받는 사람, 기념일, 성격을 고르세요. 검색 엔진이 현지 상점의 상품 설명을 읽고 어울리는 것을 추려 줍니다. 무료, 가입 없음.
같은 날의 다른 뉴스
전체 보기 →
관련 카테고리: AI
전체 보기 →
알리바바 Qwen 4 Max, 中 AI 에이전트 1위지만 다운로드 불가
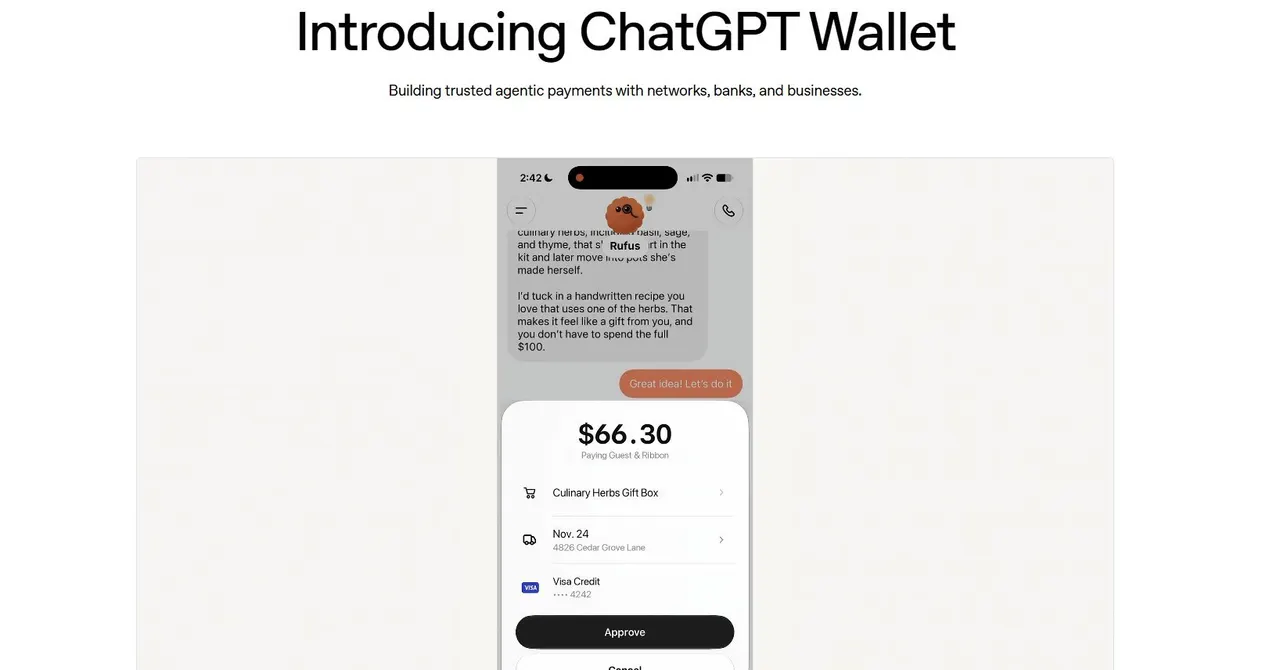
ChatGPT Wallet, dots가 대신 결제하지만 카드번호는 안 넘긴다
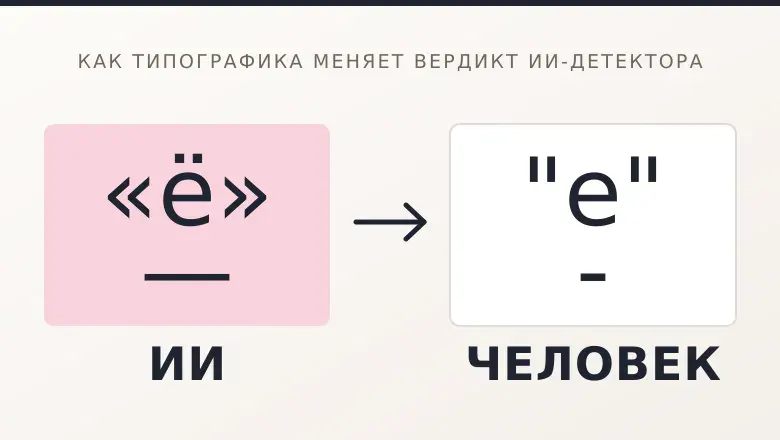
Dumate·Antiplagiat, 기호만 바꿔도 AI 판정이 달라졌다