格安GPTのシャドーAPI、24件中11件が申告モデルと不一致
GPT-5やGeminiを安く使えると謳う非公式の「シャドーAPI」を研究者が検証。調べた24の接続先のうち11件は、申告どおりのモデルと判定されなかった。
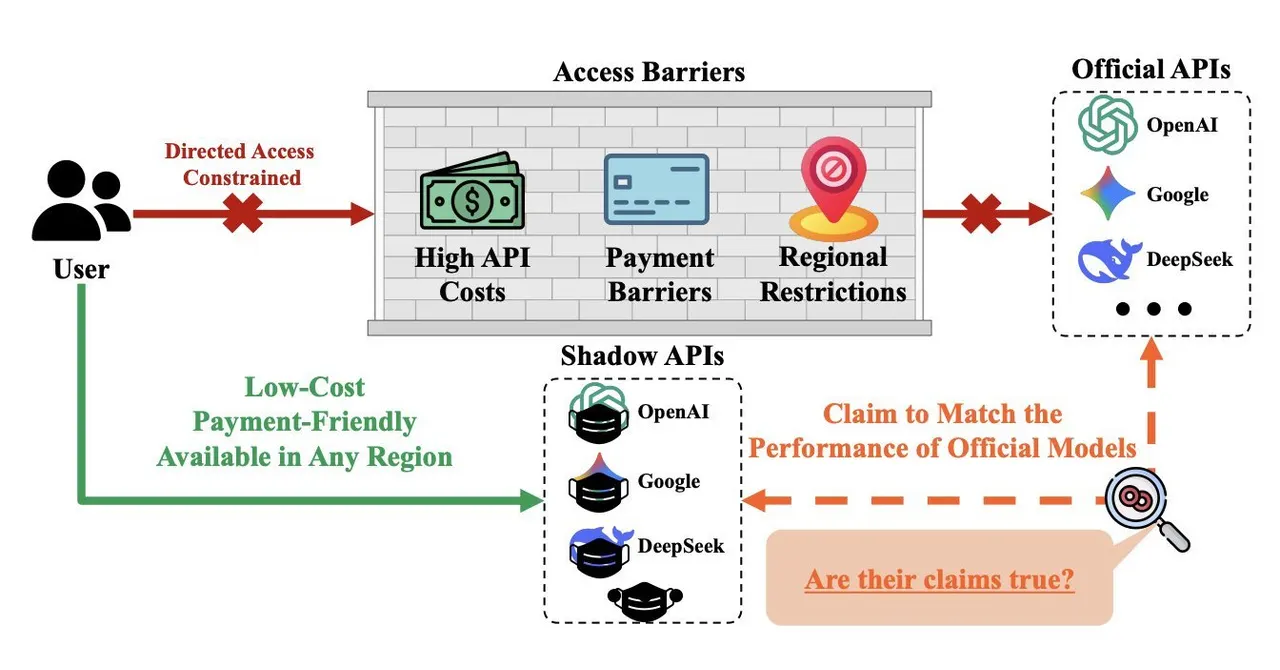
安く使えるGPT-5やGemini-2.5の正体は、別のモデルかもしれない。ドイツのCISPAとカナダのウォータールー大学の研究者らが、非公式の「シャドーAPI」を調べた論文「Real Money, Fake Models: Deceptive Model Claims in Shadow APIs」を公表した。
シャドーAPIとは何か
シャドーAPIは、LLM(大規模言語モデル)の公式APIを安く仲介すると謳う非公式サービスだ。公式APIには高い利用料金や決済のハードル、中国やロシアなど一部地域からのアクセス制限がある。それを避けられるとして広まっている。
研究チームが国際会議の採択論文やGitHubを調べたところ、17種類のシャドーAPIが見つかり、計187本の学術論文で使われていた。約62%(116本)はACL、CVPR、ICLRなどの査読付き会議や学術誌に採択されている。利用者の約8割は中国の機関所属だった。17サービスのうち15は身元を検証できない個人が運営し、すでに4つが停止していた。
申告どおりのモデルが動いているのか
人気の3サービスで、OpenAI、Google、DeepSeekの計8モデルを数学・科学分野で比較した。医療・法律・安全性は各社1モデルずつで試している。推論を要しないタスクは公式に近いスコアだったが、推論モデルでは大きく落ちる例があった。AIME 2025では、あるサービスでGemini-2.5-proが40.00ポイント、DeepSeek-Reasonerが38.89ポイント低下した。
MedQAでは、Gemini-2.5-flashの正解率が公式の83.82%に対し、3サービスすべてで約37%だった。LegalBenchでも大きく下がった。ジェイルブレイク耐性のテストでは、有害性スコアが公式の5倍になる例もあれば、大幅に低い例もあり、ずれ方は読めなかった。
応答パターンから割り出す指紋の手法と統計的検定で正体を調べると、24の接続先のうち45.83%(11件)が申告どおりと判定されなかった。GPT-5やGPT-4o-miniとして売られる接続先が、安価なオープンソースのGLM-4-9BやQwen2.5-7Bの指紋と一致した例がある。思考モードを持つDeepSeek-Reasonerが、持たないDeepSeek-Chatのように動いた例もあり、すり替えが疑われる。一方、Gemini-2.5-flashは指紋が一致したのに、医療で約47ポイント、法律で40〜43ポイント正解率が落ちた。
注目のアプリ
 SUMO:数字パズル
正しいマスを選んで足し算、目標の数に。覚えるのは簡単、極めるのは難しい。無料、全年齢向け。
 Dialo:話して学ぶ語学アプリ
AIの会話パートナーと話すだけ。一文ごとに添削され、あなたの言語で解説が返ってきます。9言語、A1からC2まで。
 ediviewer:EDIファイルを文書のように読む
EDIFACTやX12メッセージを開き、各セグメントの意味を表示。JSON/XML変換、PDF・Excel出力。ローカルで動作、アップロード不要。
 giftdetect:数分でぴったりの贈り物
相手、シーン、性格を選ぶだけ。検索エンジンが地元ショップの商品説明を読み、合うものを並べます。無料、登録不要。
同じ日のニュース
すべて見る →
関連カテゴリ: AI
すべて見る →
OpenAIをアリゾナ州が刑事捜査、銀行への不正AIエージェント侵入疑い
Google検索を学校で停止へ、NYやLAが代替を検討
Samsung SmartThingsがChatGPT連携、チャットで家電を操作