NVIDIA論文、会話を要約しても大半のAIエージェント性能を維持
NVIDIAの研究チームは、長い作業の途中で会話を要約して短くしても、AIエージェントの性能は大半で保たれたと発表した。長い文脈は運用コストも膨らむ。
NVIDIAの研究者12人は11月3日、論文公開サイトarXivに論文を投稿し、長い作業の途中で会話内容を要約して短くしても、AIエージェントの性能は大半で維持されたと報告した。文脈を長くするほど性能が上がるという通説に疑問を投げかける結果だ。ここでの文脈とは、AIが回答を作る際に一度に参照する会話や資料の量を指す。
長い文脈は生成コストが膨らむ
研究チームは、文脈が長くなるほど後から生成するトークンのコストが高くなると指摘する。論文によれば、重みが公開された最新モデルではその差が最大7倍に達する。256Kの文脈で運用した場合の1トークン当たりコストは、16Kと比べてZ.aiのGLM 5.2で3.6倍、Moonshot AIのKimi K2.6で5.6倍、AlibabaのQwen3 Coder Nextで7倍だった。
要約方式の結果
会話が一定の長さに達した時点で要約して作業を続ける方式を、SWE-bench VerifiedやTerminal-Bench 2.1、FRAMES、BFCLv3など6種の長時間タスクで試した。主に使ったのはAnthropicのClaude Opus 4.5とOpenAIのGPT 5.6 Solだ。文脈の上限と要約開始の長さを変えた22設定のうち、基準より2点を超えて下がったのは5設定以下だった。
資料を丸ごと読ませるより、必要部分だけ選んで読ませる方が良い例もあった。LOONGの1,600問で、Claude Opus 4.5に資料全体を入れると平均70.1点、完全正答率38.9%。必要部分の選択と要約で文脈を1万6,000トークン以下に保つと、平均79.3点、完全正答率53.4%に上昇した。
一方、付録ではQwen3 Coder Nextに16K設定で要約方式を適用すると、コーディング課題の成功率が53.0%から3.6%へ急落し、論文は「catastrophically collapses」と表現した。研究チームは自然言語の状態記述を読んで行動し書き換える「Semantic State Space Model」も提案したが、学習や評価は行っていない。
論文は「長文脈言語モデルが必要かを疑問視する」と結論づけた。文脈長の競争が続く中、何を残し何を要約するかがコストと性能を左右するという指摘だ。
注目のアプリ
 SUMO:数字パズル
正しいマスを選んで足し算、目標の数に。覚えるのは簡単、極めるのは難しい。無料、全年齢向け。
 Dialo:話して学ぶ語学アプリ
AIの会話パートナーと話すだけ。一文ごとに添削され、あなたの言語で解説が返ってきます。9言語、A1からC2まで。
 ediviewer:EDIファイルを文書のように読む
EDIFACTやX12メッセージを開き、各セグメントの意味を表示。JSON/XML変換、PDF・Excel出力。ローカルで動作、アップロード不要。
 giftdetect:数分でぴったりの贈り物
相手、シーン、性格を選ぶだけ。検索エンジンが地元ショップの商品説明を読み、合うものを並べます。無料、登録不要。
同じ日のニュース
すべて見る →

関連カテゴリ: AI
すべて見る →
Meta、最小・最安のAIモデル「Muse Ember」公開 入力0.10ドル
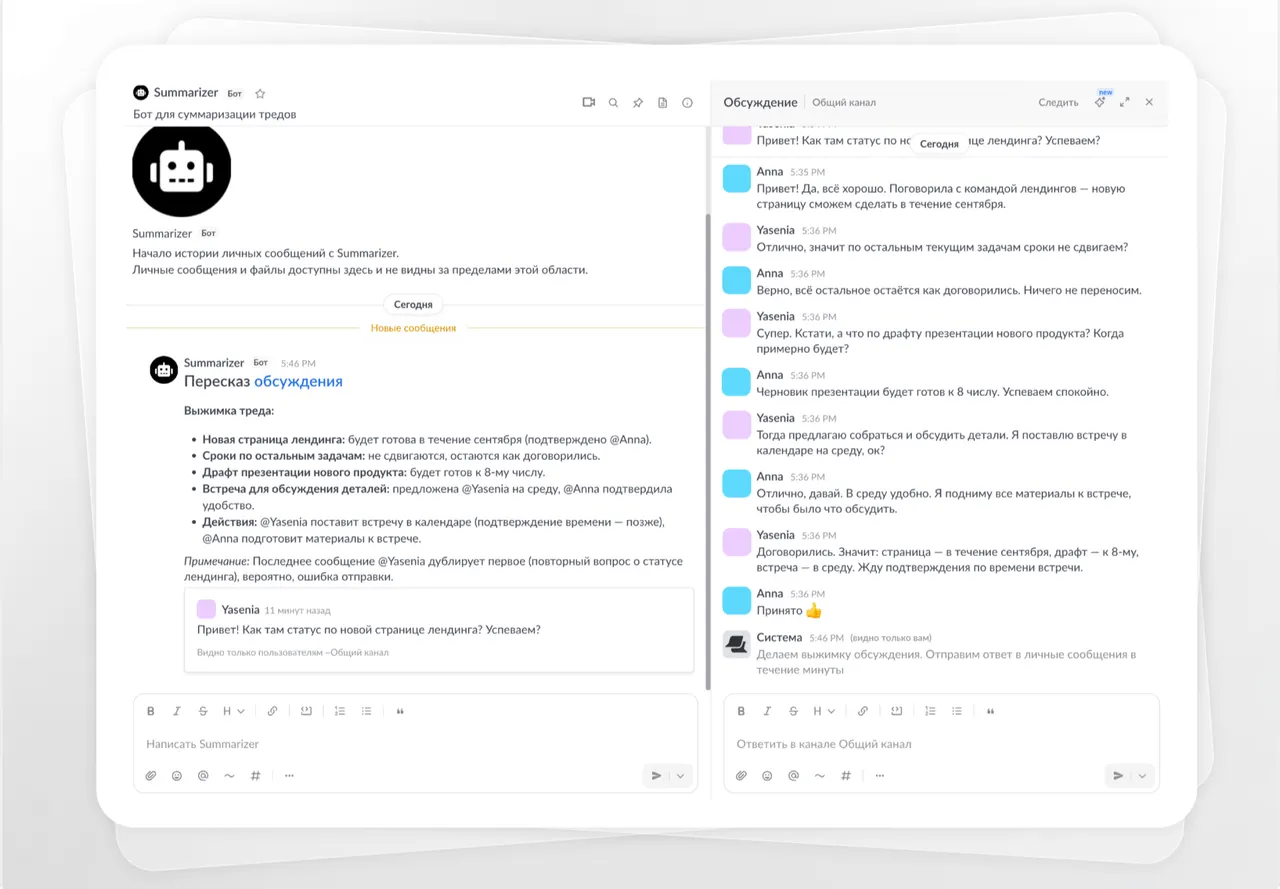
T-Bank、Timeに生成AIアシスタントとMCPサーバーを追加