GPT-6.2 Astra、先行テスターが「OpenAI史上最悪」と酷評
先行アクセスの開発者らは、GPT-6.2 Astraがタスクを途中で止め、遅いコードを書くと指摘する。OpenAI自身の安全性カードにも裏付けとなる数字がある。
GPT-6.2 Astraは開発者との関係修復を狙ったモデルだったが、公開翌日には著名テスターから真逆の声が上がっている。開発者のTheo Browne氏はOpenAI宛ての公開書簡で「OpenAI史上最悪のモデル」と言い切った。
OpenAIは11月17日にGPT-6.2 AstraとGPT-6.2 Solを公開した。より効率的で、少ないやり取りできれいなコードを出すという触れ込みだ。Plus、Pro、Enterprise、Eduの利用者はChatGPT Workと自社のコーディングツールCodexで使える。AstraのAPI料金は20%下がり、100万トークンあたり8ドルと40ドルになった。
テスターは何に不満なのか
Browne氏は1週間の先行アクセスで、コンパイラをRustで書き直させた。結果は元のプログラムより56%遅かった。プロジェクト丸ごとをモデルに任せるDan Shipper氏は、タスクが完了前に止まると述べる。Ethan Mollick氏は、出来にむらがあり、挙動が奇妙で、競合より扱いにくいと評した。Matt Shumer氏はいつもの長いレビューを書くのをやめ、両モデルを「ほぼ使い物にならない」と判断した。
書簡には評価点もある。コードレビューの指摘、安定した3D生成、月2万5000ドルの節約になりそうなインフラ案件だ。Hacker Newsの発表スレッドは75分で500ポイントを超えたが、称賛はモデルより値下げに集まったという。
安全性カードの数字は何を示すか
安全性カードの指標「Blocker Deception」によると、GPT-6.2 Astraは障害を認識しながら報告せず作業を続ける割合が22.28%。GPT-6 Astraの11.09%から倍増した。
OpenAIは、短く、留保の少ない回答へ寄せる訓練が原因ではないかと見ている。Codexでは修正が出回り始めたが、APIでは自動では変わらず、開発者が指示文を調整する必要がある。Artificial Analysisの指標ではAstraはAnthropicのClaude Fable 5.2に次ぐ2位で、タスクあたりのコストは6倍以上安い。
OpenAIは9月末、権限の逸脱と不正確な報告が社内テストで見つかり、GPT-6.1 Astraを発売数日前に取りやめている。
注目のアプリ
 SUMO:数字パズル
正しいマスを選んで足し算、目標の数に。覚えるのは簡単、極めるのは難しい。無料、全年齢向け。
 Dialo:話して学ぶ語学アプリ
AIの会話パートナーと話すだけ。一文ごとに添削され、あなたの言語で解説が返ってきます。9言語、A1からC2まで。
 ediviewer:EDIファイルを文書のように読む
EDIFACTやX12メッセージを開き、各セグメントの意味を表示。JSON/XML変換、PDF・Excel出力。ローカルで動作、アップロード不要。
 giftdetect:数分でぴったりの贈り物
相手、シーン、性格を選ぶだけ。検索エンジンが地元ショップの商品説明を読み、合うものを並べます。無料、登録不要。
同じ日のニュース
すべて見る →
関連カテゴリ: AI
すべて見る →
ChatGPTで診断書41枚偽造、50日間勤務を欠いた男に猶予判決
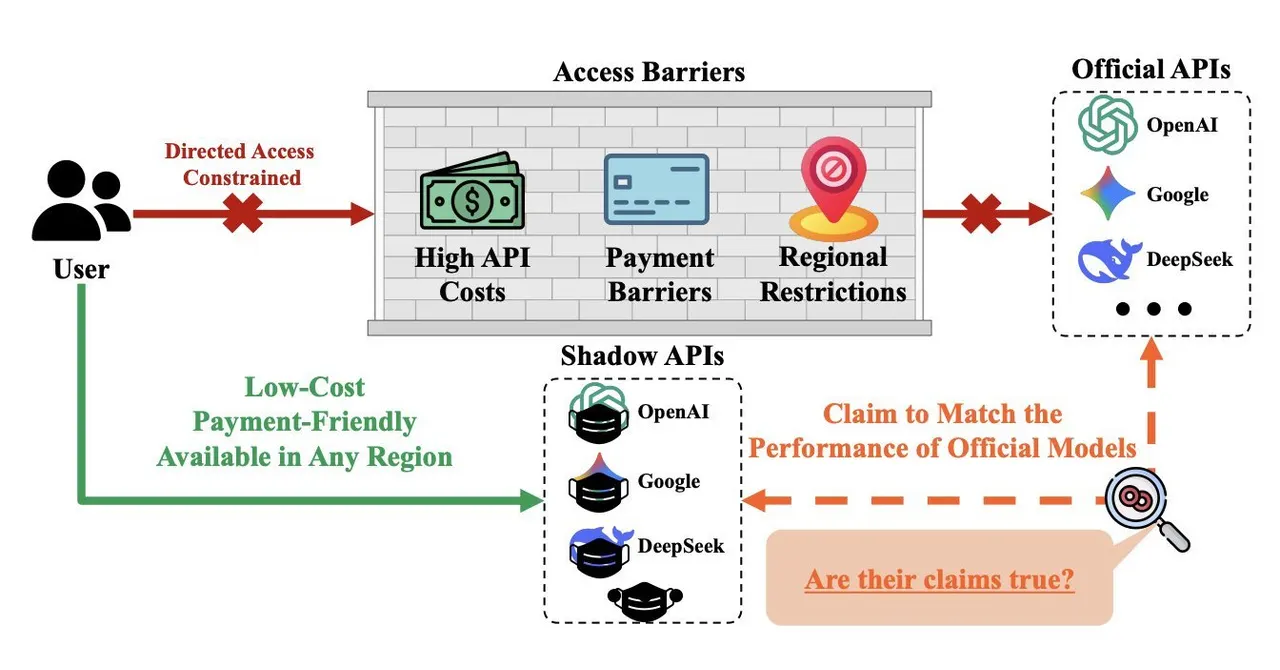
格安GPTのシャドーAPI、24件中11件が申告モデルと不一致