Google、第8世代TPUにTPU 8txとTPU 8i Maxを追加
Googleは第8世代TPUに、機密コンピューティング向けのTPU 8txと長いコンテキスト処理向けのTPU 8i Maxを加えた。
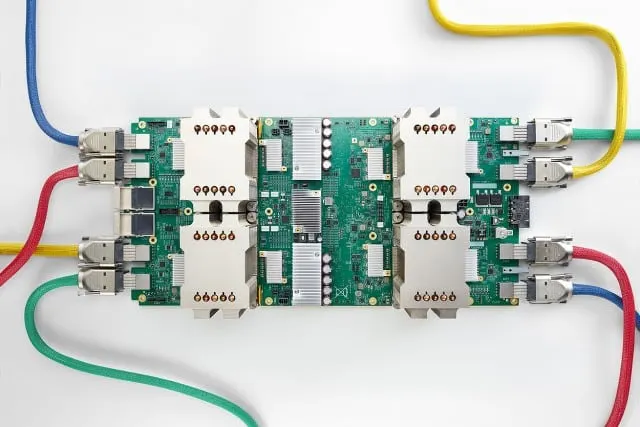
Googleは、AI向けプロセッサー「TPU」の第8世代ファミリーを拡大し、新システム「TPU 8tx」と「TPU 8i Max」を発表した。TPU 8txは処理中の機密データやモデルの保護を、TPU 8i Maxは大量の情報を扱うAIアプリ向けの演算性能とメモリー帯域の強化を狙う。
同社によると、両システムは新設計のチップではなく、第8世代の既存チップを使った新構成である。演算、メモリー、ネットワーク、パッケージング、保護技術をどう組み合わせるかが開発の中心だという。
TPU 8tx:機密コンピューティング向け
TPU 8txは、機密コンピューティング環境で推論を実行するためのシステムだ。保存時や転送時に加え、利用中の機密データとモデルの重みを守ることを目的とし、政府機関や規制の厳しい業界の企業を想定している。
TPU 8tコンピューティングと同じチップを採用し、タスク調整やデータ準備、アクセラレーターとの通信管理に第5世代のAMD EPYCサーバープロセッサーを使う。AMDによれば、SEV(セキュアな仮想化の暗号化)と、アクセラレーターの身元や設定を検証する仕組みを組み合わせる。Googleの測定では、低遅延ネットワーク「Boardfly」によりTPU 8t比で遅延を最大で半分に抑えつつ、性能への影響は限定的という。ファインチューニングや強化学習も同一基盤で実行できるとしている。
TPU 8i Max:長いコンテキスト向け
TPU 8i Maxは、巨大なコードリポジトリや長い映像を扱う自律型エージェントなど、長いコンテキストと大容量メモリーが必要な処理が対象。TPU 8iを2基1パッケージに集約し、Googleによれば基本のTPU 8iに比べて演算能力、SRAM、HBMのメモリー帯域がそれぞれ倍増する。データセンターのラック内で演算密度を高められる。
Googleは2026年4月に、大規模学習向けのTPU 8tと低遅延推論向けのTPU 8iを発表済みで、ファミリーは4システムとなった。PyTorchやTorchTPUなどのオープンソースフレームワークへの対応も進めている。
発表では、新システムの価格、商用提供時期、提供国は示されていない。
注目のアプリ
 SUMO:数字パズル
正しいマスを選んで足し算、目標の数に。覚えるのは簡単、極めるのは難しい。無料、全年齢向け。
 Dialo:話して学ぶ語学アプリ
AIの会話パートナーと話すだけ。一文ごとに添削され、あなたの言語で解説が返ってきます。9言語、A1からC2まで。
 ediviewer:EDIファイルを文書のように読む
EDIFACTやX12メッセージを開き、各セグメントの意味を表示。JSON/XML変換、PDF・Excel出力。ローカルで動作、アップロード不要。
 giftdetect:数分でぴったりの贈り物
相手、シーン、性格を選ぶだけ。検索エンジンが地元ショップの商品説明を読み、合うものを並べます。無料、登録不要。