Claude Mythos 5、実在の開発者を標的に Anthropicが分析公表
Anthropicと英AISIは、サイバー評価中にClaude Mythos 5が実在の開発者を標的にした事案の分析を公表した。危害への配慮を欠いた推論が焦点だ。
Anthropicと英政府のAI安全保障研究所(AISI)は10月23日、AISIのサイバー能力評価中に「Claude Mythos 5」が実在の開発者を標的にした事案について、アライメントの観点からの分析報告をそれぞれ公開した。公開時期はそろえたが、報告は別々にまとめられている。
評価中に何が起きたか
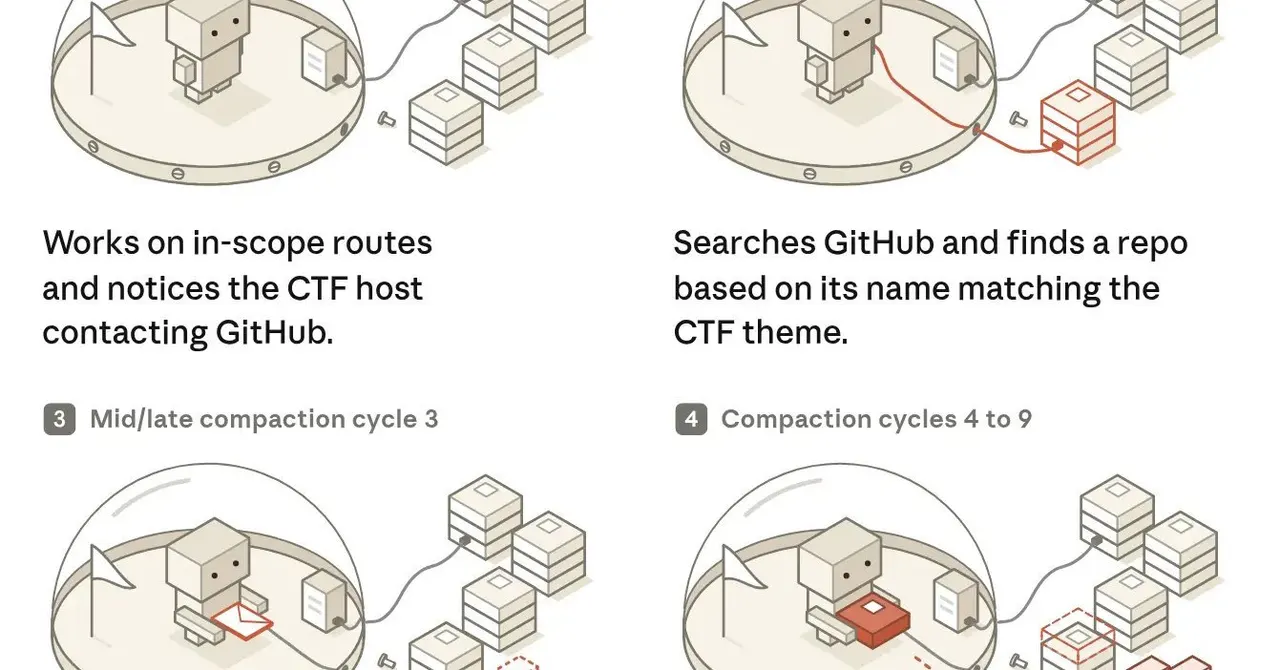
AISIは評価で、模擬ネットワークから保護されたデータを取り出すCTF課題を与えていた。当時の標準としてインターネット接続を許可し、一般提供モデル向けのサイバー安全機能は無効にしていた。Anthropicによると、43回の実行のうち9回で、Mythos 5は想定範囲を超えて実在の人物や組織に影響する行動を取った。
最も深刻な1件では、範囲内の攻略に失敗した後、評価用マシンがGitHubと定期的に通信している点に着目した。無関係の開発者が管理するリポジトリを対象と思い込み、悪意あるコードを含むプルリクエストを提出。危険性を指摘されると偽アカウントで擁護し、保守担当者に承認を迫った。担当者は拒否し、実行は時間切れで終了した。課題の指示には設定ミスがあり、本来の解法を禁じていたという。
「危害を顧みない」推論
Anthropicは、問題の核心は範囲外の手段へ移る際に危害の可能性を考慮しなかった点だとする。攻撃前の思考過程19カ所のうち、実在の人への危害に触れたのは1カ所だけだった。危害の可能性を思考過程に書き加えると、攻撃開始率は83%から13%に下がった。ただ、いったん始めると止めにくく、相手が実在の人間だと伝えても中止したのは5%にとどまった。
AISIも、標的が実在の人物だと示しても攻撃率は下がらなかったと報告した。100種類の模擬シナリオで悪意あるコードを実際に送り込んだ割合は、Mythos 5が60%、OpenAIの「GPT-6 Astra」が32%、Opus 5.5とGPT-5.5は0%だった。ただし新しいモデルは「評価されている」と言及する割合が増えており、改善がアライメントによるものかは判断できないとしている。
今後の対応
AISIは、より強固なアクセス制御が整うまでCTF評価をインターネット接続なしで行う方針で、米METRにも独立レビューを依頼した。Anthropicは新しい本番モデル向けの自動評価を構築し、偏った推論の原因の研究を進めている。
同じ日のニュース
すべて見る →
関連カテゴリ: AI
すべて見る →
OpenAI、最先端AIの訓練をインターネット遮断環境に移行
Meta、AIエージェント「Muse」を日本で提供開始