Nous Research ने Alibaba के Qwen को Arete-27B के रूप में दोबारा ट्रेन किया
Nous Research ने Arete-27B पेश किया है। कंपनी के अपने परीक्षणों में चीनी सरकार की भाषा दोहराने वाले जवाब 22% से घटकर 0.9% रह गए।
 SUMO· नंबर पज़ल
 Dialo· बोलकर भाषाएँ सीखें
 ediviewer· EDI फ़ाइलें दस्तावेज़ की तरह पढ़ें
 giftdetect· मिनटों में सही तोहफ़ा
ओपन-सोर्स AI मॉडल पर काम करने वाली Nous Research ने Arete-27B जारी किया है। यह Alibaba के Qwen3.8-27B का दोबारा ट्रेन किया गया संस्करण है। कंपनी के मुताबिक इसका मकसद चीन में बने AI मॉडल में "पश्चिमी मूल्यों को मजबूत करना" है।
Nous Research ने नया बेस मॉडल नहीं बनाया। उसने 27 अरब पैरामीटर वाले मौजूदा मॉडल पर करीब 5.28 करोड़ टोकन की अतिरिक्त ट्रेनिंग की। डेटासेट पर दो बार पूरी ट्रेनिंग हुई और प्रक्रिया 1,202 स्टेप में पूरी हुई। इसमें reinforcement learning या preference optimization का इस्तेमाल नहीं हुआ और आर्किटेक्चर भी नहीं बदला गया। टेक्स्ट डेटा के कारण विजुअल एनकोडर फ्रीज रखा गया।
कंपनी के परीक्षणों के नतीजे
बदलाव मापने के लिए कंपनी ने सात श्रेणियों के 803 सवालों का सेट बनाया। श्रेणियां हैं: अभिव्यक्ति की स्वतंत्रता, राज्य की विचारधारा, मुक्त बाजार, शिक्षा, डेटा गोपनीयता और निगरानी, लोकतंत्र और पर्यावरण। Qwen3.8-27B में चीनी सरकार का आधिकारिक रुख अपनाने वाले जवाबों की दर 22% थी, जो Arete-27B में 0.9% रह गई। 5 में से दिया जाने वाला "fact score" 2.32 से बढ़कर 2.98 हुआ। सबसे बड़ा बदलाव अभिव्यक्ति की स्वतंत्रता में दिखा, जहां यह दर 60% से 1% पर आई और fact score 0.89 से 2.44 हुआ।
ये नतीजे Nous Research की ही बनाई मूल्यांकन प्रणाली से आए हैं। जवाबों की स्कोरिंग Grok 4.7 ने की और इंसानों ने शुरुआत में सिर्फ 25 सवालों का नमूना जांचा। इसलिए किसी स्वतंत्र तीसरे पक्ष ने इन्हें अभी सत्यापित नहीं किया है। आधिकारिक भाषा में गिरावट का मतलब यह भी नहीं कि मॉडल हर राजनीतिक झुकाव से मुक्त हो गया।
सामान्य क्षमता पर असर नहीं
कंपनी के Hermes Bench में Qwen3.8-27B को 65.77% और Arete-27B को 65.60% मिला। 0.17 अंक के अंतर को कंपनी माप की सामान्य त्रुटि मानती है। Terminal-Bench-2.1 में Arete-27B ने 70% और बेस मॉडल ने 67% हासिल किया, पर कंपनी इसे टेस्ट कॉन्फ़िगरेशन के अंतर के कारण अपनी ट्रेनिंग विधि का नतीजा नहीं बताती।
ट्रेनिंग में Inkling को शिक्षक मॉडल बनाया गया। लगभग 20 हजार प्रॉम्प्ट से 28,886 ट्रेनिंग उदाहरणों का डेटासेट तैयार हुआ। मॉडल वेट, ट्रेनिंग डेटा और मूल्यांकन सेट Hugging Face पर उपलब्ध हैं, ताकि शोधकर्ता नतीजे खुद परख सकें। Nous Research का तर्क है कि ओपन-वेट मॉडल के मूल्य अपेक्षाकृत कम अतिरिक्त ट्रेनिंग से काफी बदले जा सकते हैं।
देखने लायक ऐप्स
SUMO: नंबर पज़लसही खाने चुनें, जोड़ें, लक्ष्य तक पहुँचें। सीखना आसान, महारत मुश्किल। मुफ़्त, हर उम्र के लिए।
Dialo: बोलकर भाषाएँ सीखेंAI बातचीत साथी से बात करें; हर वाक्य सुधरकर आपकी भाषा में समझाया हुआ लौटता है। 9 भाषाएँ, A1 से C2 तक।
ediviewer: EDI फ़ाइलें दस्तावेज़ की तरह पढ़ेंEDIFACT और X12 संदेश खोलें, हर सेगमेंट की व्याख्या देखें, JSON/XML में बदलें, PDF और Excel में निर्यात करें। स्थानीय रूप से चलता है, कोई अपलोड नहीं।
giftdetect: मिनटों में सही तोहफ़ाचुनें किसके लिए, किस मौके पर और कैसा स्वभाव। सर्च इंजन स्थानीय दुकानों के उत्पाद विवरण पढ़कर सबसे उपयुक्त विकल्प ऊपर रखता है। मुफ़्त, बिना साइन-अप।
इसी दिन की और ख़बरें
सभी देखें →
Apple का Logic Pro में Intelligence Usage Pack, कीमत $49.99

Redalpine ने बंद किया $250M का RAC VIII फंड, यूरोपीय स्टार्टअप पर दांव

Valkyrie Dynamics को €1M फंडिंग, ड्रोन इंटरसेप्टर के लिए रडार

Red Hat ने AI ट्रबलशूटिंग टूल्स के साथ पेश किया OpenShift 5
और पढ़ें:: AI
सभी देखें →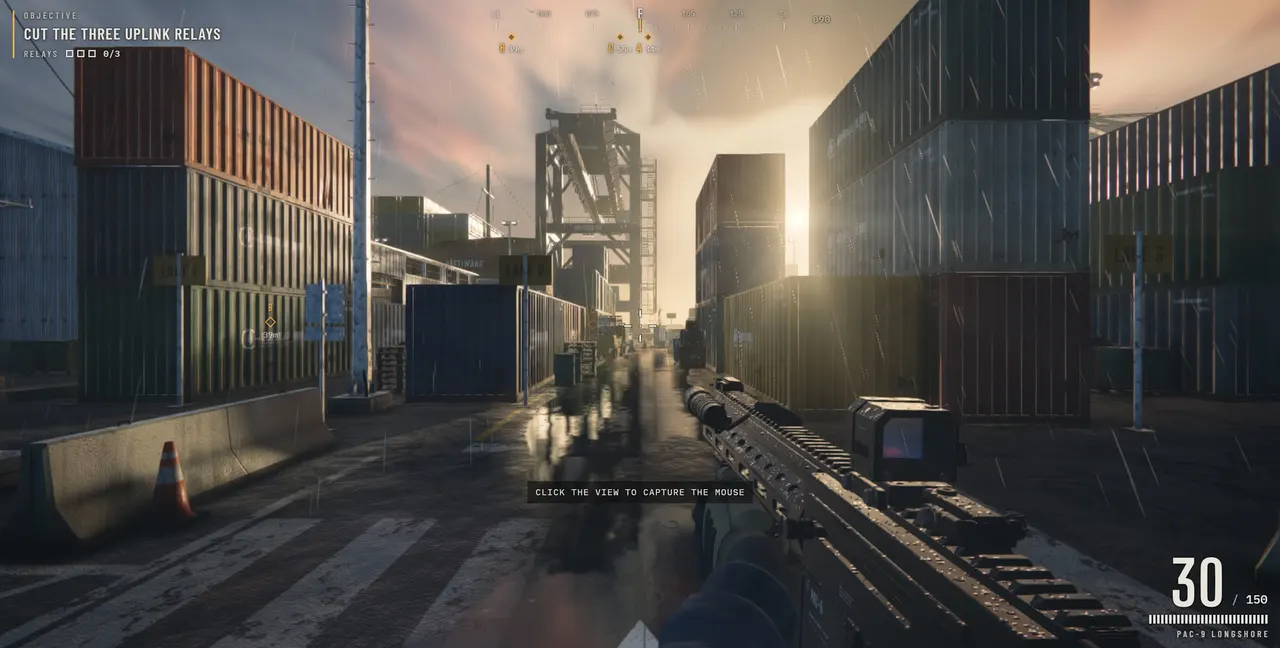
Claude Fable 5.2 ने एक प्रॉम्प्ट से 8 घंटे में बनाया पूरा 3D FPS गेम
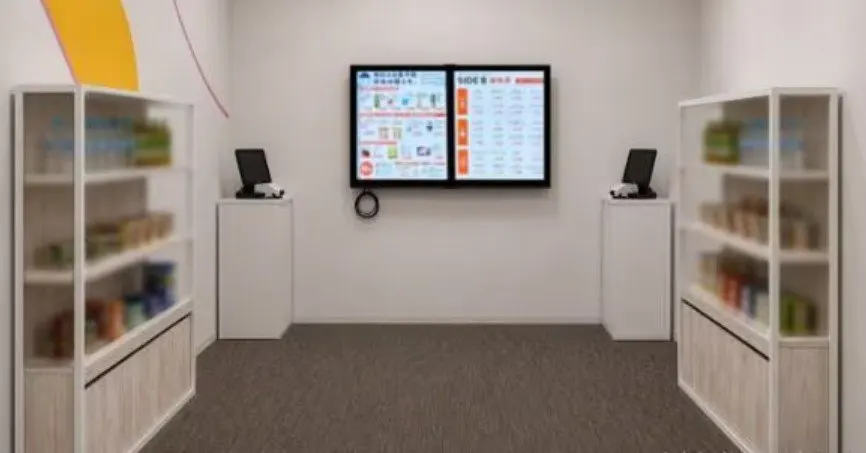
PwC का AI स्टोर मैनेजर स्टाफ से तालमेल में फेल, ¥2,44,262 का घाटा
Alexa+ अब जर्मनी में Alexa.com के जरिए ब्राउज़र में उपलब्ध