Inkling 2 Mini : une IA ouverte de 26 milliards de paramètres en local
Thinking Machines Lab a fait coder un simulateur de vol jouable à Inkling 2 Mini sur un MacBook Pro sans Wi-Fi. Ce modèle ouvert tient dans moins de 20 Go.
 SUMO · le puzzle de nombres
 Dialo · apprenez les langues en parlant
 ediviewer · lisez les fichiers EDI comme des documents
 giftdetect · le bon cadeau en quelques minutes
Pour prouver qu'Inkling 2 Mini n'a pas besoin d'internet, l'équipe de Thinking Machines l'a emporté en avion. Sur un MacBook Pro privé de Wi-Fi, le modèle a codé un simulateur de vol jouable en quelques minutes, assure la start-up.
Thinking Machines Lab, fondée en 2025 par Mira Murati, ancienne directrice technique d'OpenAI, a publié ce modèle le 20 novembre, deux semaines après Inkling 2 Small, bien plus gros avec ses 594 milliards de paramètres. Certains le trouvaient trop volumineux, d'où Inkling 2 Mini et ses 26 milliards. Il vise le développement logiciel et les agents autonomes, capables d'enchaîner seuls des actions. Les poids sont distribués sous licence libre Apache 2.0, usage commercial inclus.
Comment Inkling 2 Mini tient-il dans moins de 20 Go ?
Grâce à trois astuces. D'abord, il a été entraîné directement en NVFP4, un format 4 bits de Nvidia, avec seulement les quatre dernières couches en 8 bits. En 16 bits, il dépasserait 50 Go.
Ensuite, c'est un modèle en mélange d'experts : chaque couche compte 128 sous-réseaux spécialisés, dont 8 seulement traitent chaque jeton (un fragment de mot). Seuls 3,4 milliards de paramètres sont donc actifs à un instant donné. Il y avait au départ 384 experts par couche ; les deux tiers les moins sollicités ont été élagués, puis les autres réentraînés.
Enfin, le modèle boucle sur lui-même. Sur 24 couches, les 12 centrales sont parcourues trois fois par jeton, ce qui donne la profondeur de raisonnement d'un modèle de 48 couches sans mémoire en plus. La start-up annonce 140 % de calcul économisé sur les tâches d'agent complexes.
Quelles sont ses performances ?
Sur DeepSWE v1.1, qui mesure la capacité d'une IA à corriger seule de vrais bugs, Inkling 2 Mini en résout 48,2 %, contre 42,2 % pour Qwen3.8-27B d'Alibaba. Ces chiffres viennent du laboratoire et n'ont pas été vérifiés de façon indépendante.
Qwen3.8 reprend l'avantage ailleurs : il converse mieux et invente moins, avec 71,4 % de réponses fiables sur AA-Omniscience contre 63,4 %.
Quelle configuration faut-il ?
La version 4 bits recommandée par Unsloth pèse 17,6 Go, plus la place pour le contexte. Conviennent par exemple un Mac avec 32 Go de mémoire unifiée, un PC AMD Ryzen AI Max+ 395, un portable Intel Panther Lake de 32 Go ou une carte graphique de 24 Go de VRAM. Selon Unsloth, 16 Go de RAM peuvent suffire avec une compression plus agressive, au prix d'une légère perte de précision. On l'utilise avec Ollama, LM Studio, Unsloth Desktop ou llama.cpp (support encore expérimental), les fichiers étant sur Hugging Face.
Des apps à découvrir
SUMO : le puzzle de nombresTouche les bonnes cases, additionne, atteins l'objectif. Facile à apprendre, difficile à maîtriser. Gratuit, pour tous les âges.
Dialo : apprenez les langues en parlantDiscutez avec un partenaire IA ; chaque phrase revient corrigée et expliquée dans votre langue. 9 langues, de A1 à C2.
ediviewer : lisez les fichiers EDI comme des documentsOuvrez des messages EDIFACT et X12, chaque segment expliqué, conversion JSON/XML, export PDF et Excel. Fonctionne en local, sans envoi.
giftdetect : le bon cadeau en quelques minutesChoisissez pour qui, l'occasion et la personnalité. Le moteur lit les descriptions de produits de boutiques locales et classe ce qui convient. Gratuit, sans inscription.
Plus d'actus de ce jour
Tout voir →
Samsung Galaxy : des boutons cachés et des raccourcis avec Good Lock
Le plus vieux programme sous Windows 11 date de 1992
Pilote GeForce 621.35 : Nvidia stoppe les 30 Go par heure écrits sur le SSD
ARTEX : l'outil de piratage par IA qui infiltre un réseau en 3 h
Plus dans: IA
Tout voir →
Des chiens robots surveillent déjà les data centers d'IA, rentables en 2 ans
SurfSense : une alternative gratuite à NotebookLM, qui tourne hors ligne
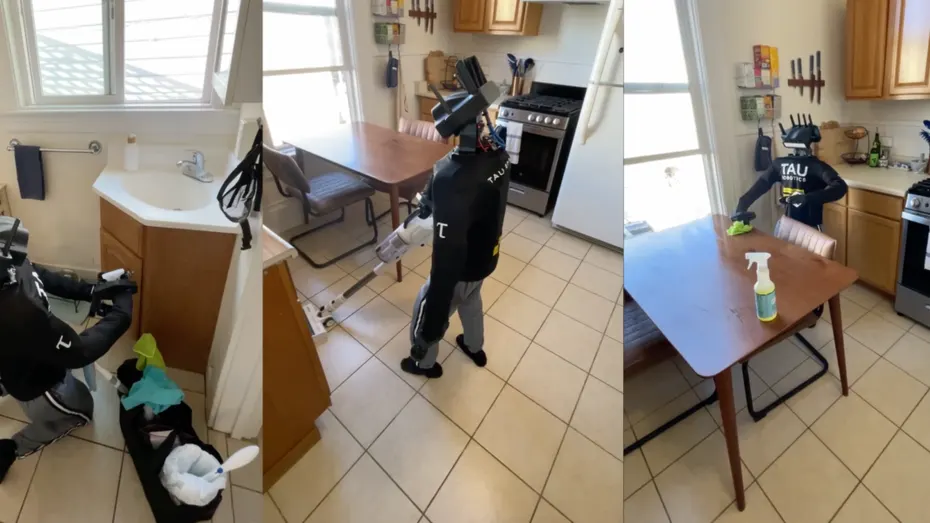
Tau Robotics : un robot humanoïde pour le ménage à 30 dollars, piloté à distance