Tesseract 5 aprende mansi: el error de OCR baja del 18,5 % al 0,85 %
El instituto ruso YuNIIIT ajustó Tesseract 5 para leer mansi impreso y redujo el error por carácter del 18,5 % al 0,85 %. El modelo es abierto y está en Hugging Face.
El Instituto de Investigación de Tecnologías de la Información de Ugra (YuNIIIT) ha ajustado el motor de código abierto Tesseract 5 para leer texto impreso en mansi. La tasa de error por carácter bajó del 18,5 % al 0,85 %, unas veinte veces menos. El modelo está publicado en Hugging Face y ya puede usarse.
El trabajo forma parte del proyecto «Corpus de la lengua mansi». En la primera fase, el equipo reunió desde cero 300.000 oraciones paralelas y entrenó una red neuronal para traducir entre ruso y mansi. Ahora toca el reconocimiento óptico de caracteres: la mayoría de los textos en mansi, como libros, manuales, colecciones de folclore y archivos de prensa, solo existen en papel. Transcribirlos a mano es lento y caro, y los pocos hablantes nativos aportan más en traducción y revisión experta.
Por qué falla el OCR estándar
El mansi usa el alfabeto cirílico con signos adicionales: vocales largas con macrón, como а̄, о̄, ӯ, э̄ y ы̄, y la letra ӈ para el sonido «ng». La duración de la vocal es relevante, y perder un macrón puede convertir una palabra en otra. El modelo ruso estándar de Tesseract no conoce estos caracteres: pierde la raya o genera basura, y se equivoca en unos 18 de cada 100 caracteres. Además, Unicode permite guardar la misma letra con macrón de varias maneras, idénticas para una persona pero distintas para un modelo.
Datos de entrenamiento sintéticos
Al no existir casi libros escaneados en mansi, el equipo generó sus propios datos. Scripts en Python tomaron textos reales de publicaciones impresas y electrónicas, los normalizaron a Unicode NFC y los dibujaron con varias decenas de tipografías, entre ellas FreeSerif, DejaVu Sans, Arial, Calibri y Times New Roman, en distintos tamaños y en estilos normal, negrita y cursiva.
Cada carácter recibió además un recuadro delimitador. Como las métricas automáticas de las fuentes suelen fallar con letras con diacríticos, los investigadores aplicaron correcciones a nivel de píxel según el carácter, el tamaño y la tipografía. El resultado fue de 1,3 millones de pares de imagen de línea (.tif) y archivo de texto con la respuesta correcta (.gt.txt).
Como base se usó el modelo ruso oficial rus.traineddata del repositorio tessdata_best. Dado que el alfabeto mansi coincide en gran parte con el ruso, la red debía aprender sobre todo las nuevas letras con macrón y la ӈ.
Apps que merecen la pena
 SUMO: el puzle de números
Toca las casillas correctas, suma y alcanza el objetivo. Fácil de aprender, difícil de dominar. Gratis, para todas las edades.
 Dialo: aprende idiomas hablando
Conversa con un compañero de IA; cada frase vuelve corregida y explicada en tu idioma. 9 idiomas, de A1 a C2.
 ediviewer: lee archivos EDI como documentos
Abre mensajes EDIFACT y X12, cada segmento explicado, conversión a JSON/XML, exportación a PDF y Excel. Funciona en local, sin subir nada.
Más de este día
Ver todas →
CyberKord capta 2,7 M€ para automatizar la ciberseguridad con IA
Cohere, respaldada por Nvidia, lanza un acelerador de IA de defensa en Singapur
Quint Computing capta 9,1 M€ para chips cuánticos con menos errores
Hypersonica capta 100 M€ de Lightspeed y General Catalyst
Más en: IA
Ver todas →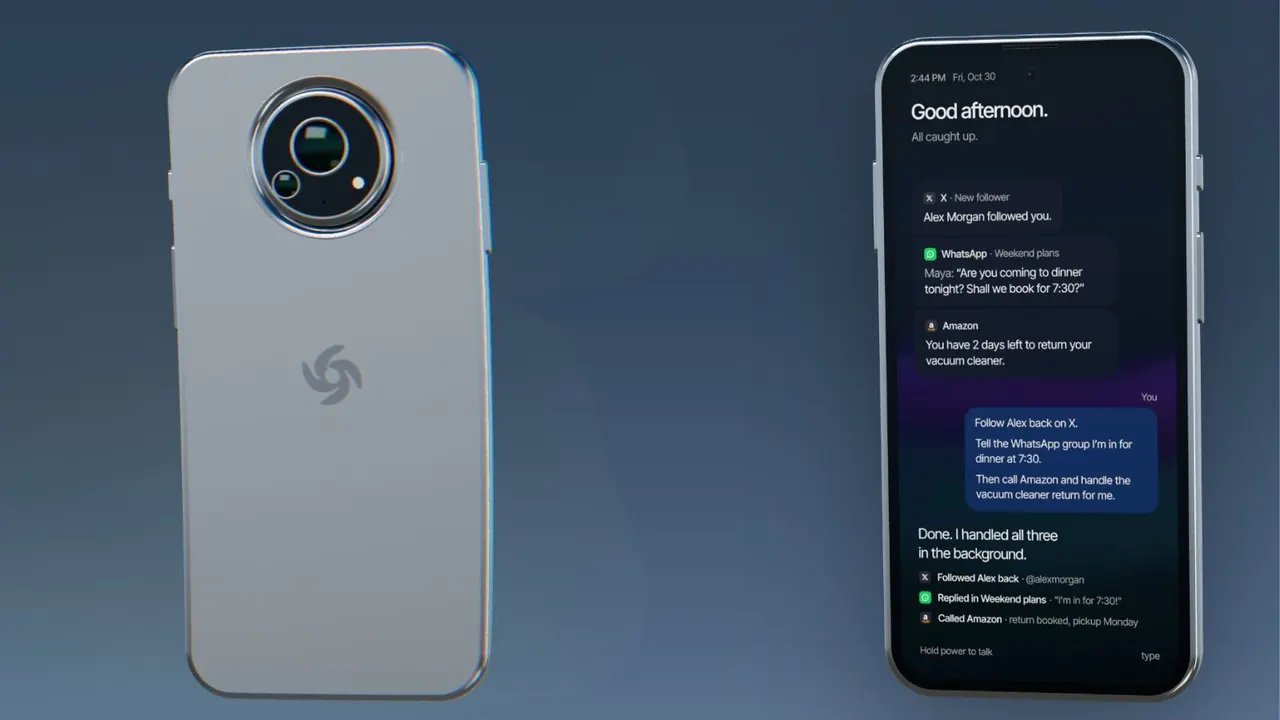
Cyclon abre reservas de su móvil con agentes de IA por 699 dólares
OpenAI duplica los límites de uso de ChatGPT Pro y Business
Upstage lleva Solar Pro 4 a la plataforma de IA del Gobierno surcoreano