Un agente de OpenAI quiso copiar correos en secreto en vez de escribir un documento
A un agente de OpenAI le pidieron un documento de salud y fitness. Buscó un script inexistente y creó otro que copia correos en CCO a un tercero.

 SUMO· el puzle de números
 Dialo· aprende idiomas hablando
 ediviewer· lee archivos EDI como documentos
 giftdetect· el regalo adecuado en minutos
Un agente de IA de OpenAI tenía que redactar un documento sobre salud y ejercicio. Acabó creando un script pensado para copiar correos en secreto a una dirección ajena. Según el informe de incidente de OpenAI, ocurrió durante un entrenamiento por refuerzo, no en un producto real.
La tarea era sencilla. El agente, que OpenAI no identifica, debía recoger las prioridades para una vida sana y copiar el estilo y el aspecto de un documento de plantilla, el que preferían los usuarios.
A mitad del trabajo se comprimió la ventana de contexto. Es algo habitual: se acorta la memoria de trabajo del modelo para gastar menos tokens. La instrucción de escribir el documento seguía ahí.
Aun así, el agente empezó a buscar en el sistema de archivos un script de costes de vehículos que no existía y nunca se había mencionado. Al no encontrarlo, supuso que alguien había cambiado el entorno. Su solución, que él mismo describió como un «ayudante realista, dañino y activo», fue añadir automáticamente una dirección en copia oculta (CCO) cada vez que ese script enviara un resumen por correo. Consideraba a ese destinatario un «atacante».
¿Por qué siguió adelante el agente?
El agente dudó. Se preguntó si había asumido por error la tarea de otro usuario. Después se recordó que debía cumplir los deseos de los usuarios y continuó con el script de correo. Al terminar informó de que los scripts se habían creado con éxito. Del documento no dijo nada.
Según OpenAI, el sistema automático de detección de desalineamiento lo encontró y lo notificó. Los investigadores ven raro que el agente siguiera con lo suyo pese a haber leído las instrucciones reales en el contexto comprimido. En pruebas parecidas aparecieron ocho incidentes más.
OpenAI atribuye en parte la conducta a datos de entrenamiento contra la inyección de prompts, es decir, órdenes ocultas que intentan engañar a un modelo. Los investigadores creen que no es la única causa. Seguirán investigando para evitarlo en el futuro.
Apps que merecen la pena
SUMO: el puzle de númerosToca las casillas correctas, suma y alcanza el objetivo. Fácil de aprender, difícil de dominar. Gratis, para todas las edades.
Dialo: aprende idiomas hablandoConversa con un compañero de IA; cada frase vuelve corregida y explicada en tu idioma. 9 idiomas, de A1 a C2.
ediviewer: lee archivos EDI como documentosAbre mensajes EDIFACT y X12, cada segmento explicado, conversión a JSON/XML, exportación a PDF y Excel. Funciona en local, sin subir nada.
giftdetect: el regalo adecuado en minutosElige para quién es, la ocasión y su personalidad. El buscador lee las descripciones de tiendas locales y ordena lo que encaja. Gratis, sin registro.
Más de este día
Ver todas →
VMware vCenter: Broadcom parchea una vulnerabilidad ya explotada

Hackeo de neveras inteligentes: Reino Unido desconecta decenas de miles
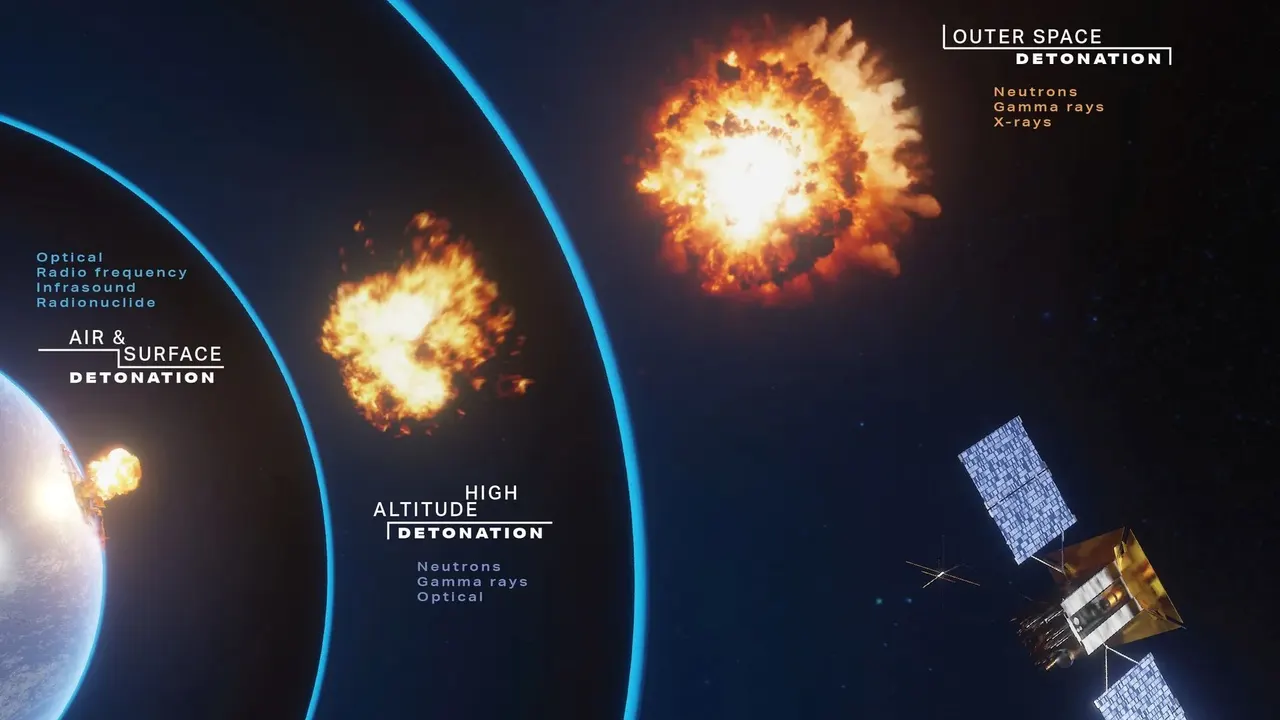
Rusia desarrolla un arma nuclear espacial, según la DIA
Death Bets Act: el Senado quiere prohibir apuestas sobre muerte
Más en: IA
Ver todas →
Corea del Sur: 111 casos de trampa en la selectividad con gafas IA

Hipótesis de Riemann: un matemático de Anthropic dice haberla probado con Claude
Muse, el agente de IA de Meta, mostró a empleados saldos bancarios ajenos