NTT stellt Physical AI vor, die Roboterfehler vorab erkennt
NTT hat eine Physical-AI-Technik vorgestellt, mit der Roboter Risiken wie herabfallende oder einstürzende Ladung vorhersehen und die erfolgversprechendste Aktion wählen.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
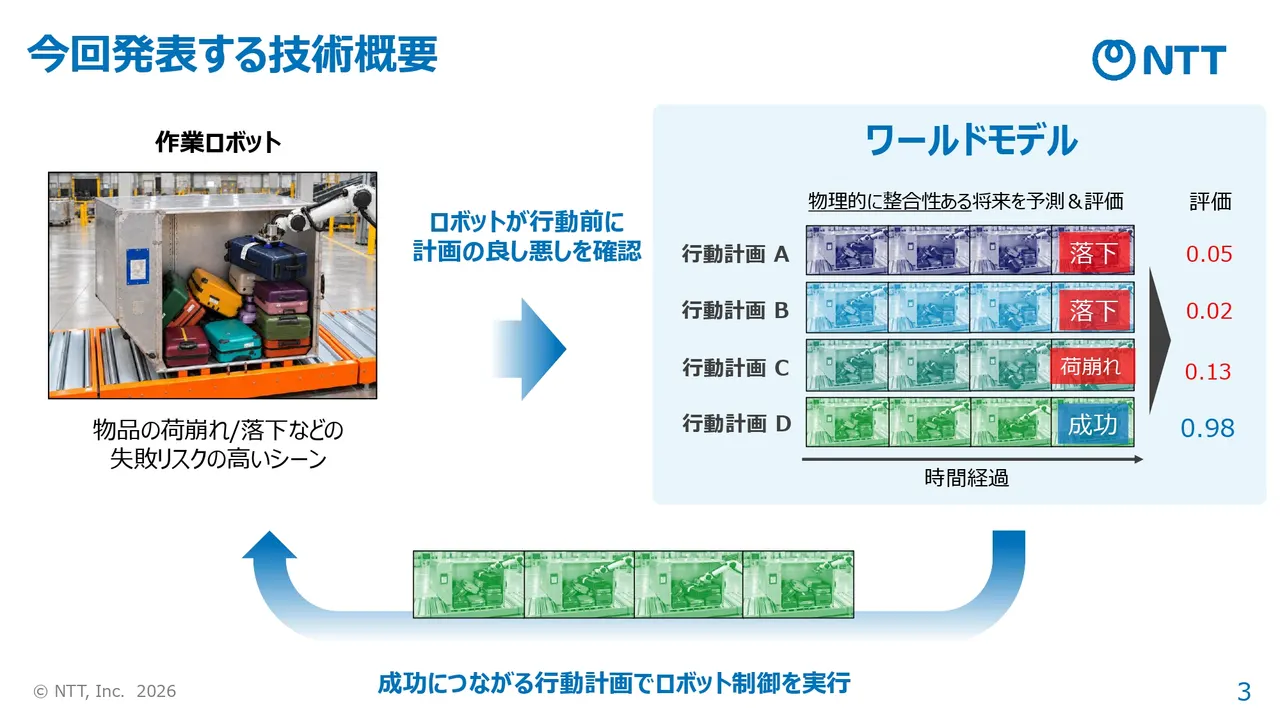
NTT hat am 11. November eine Physical-AI-Technik vorgestellt, mit der Roboter Risiken wie einstürzende Ladung oder herabfallende Objekte vorhersagen, bevor sie handeln, und anschließend die Aktion mit der höchsten Erfolgschance wählen. Grundlage ist das „NTT World Model“, das Objektbewegungen nach physikalischen Gesetzen vorausberechnet und mehrere Handlungsoptionen vorab bewertet.
Wo herkömmliche Weltmodelle scheitern
Ein Weltmodell erfasst den Zustand der Umgebung und sagt voraus, wie sich dieser durch die eigenen Aktionen des Roboters verändert. Die meisten bisherigen Modelle lernen empirisch aus riesigen Videomengen und liefern in unbekannten Situationen mitunter Vorhersagen, die der Physik widersprechen. Problematisch ist das etwa bei Flughafengepäck oder Paketen, deren Form, Gewicht und Anordnung stark variieren; Trainingsdaten für jeden Fall zu sammeln, ist kaum möglich.
Das NTT World Model kombiniert ein Videogenerierungsmodell mit einem selbst entwickelten „physikalischen Steuerungsadapter“. Dieser schätzt Position, Lage, Geschwindigkeit und Masse der Objekte und berechnet Veränderungen anhand von Bewegungsgleichungen, sodass auch Kontakte und Kollisionen nachgebildet werden. Laut NTT verhindert die Kombination unnatürliche Ergebnisse wie verschwindende oder verformte Objekte und hält Vorhersagen auch in unbekannten Situationen physikalisch konsistent.
Ergebnisse und nächste Schritte
Das System arbeitet mit vorhandener Robotersteuerung zusammen. Für mehrere Handlungsoptionen, die ein VLA-Modell (Vision-Language-Action) oder ein Motion Planner erzeugt, sagt es das Ergebnis als Video voraus und gibt für jede einen Erfolgswert aus. So kann der Roboter vergleichen, bevor er sich bewegt.
In einem Versuch, bei dem ein kleiner Roboter unförmige Objekte in ein Regal stapelte, stieg die Erfolgsquote durch die Kombination des Open-Source-VLA-Modells π0.5 mit dem NTT World Model von 73,1 auf 92,3 Prozent. Im öffentlichen Benchmark OBJ3D, der Kollisionen mehrerer Objekte enthält, erreichte es einen LPIPS-Wert von 7,81. Diese Metrik bildet ab, wie ähnlich Menschen echtes und vorhergesagtes Video wahrnehmen. Das Modell übertraf damit die Methode OCK (7,92) und NVIDIA Cosmos Predict 2.5 (21,90); niedriger ist besser.
Erstes Einsatzfeld soll das Be- und Entladen von Flughafengepäck mit unterschiedlichen Formen und Gewichten sein. NTT will die Technik gemeinsam mit Mujin erproben und später in Logistik und Lagerhaltung, Fertigung, Bau und Einzelhandel einsetzen.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Google Wallet: Digitale Haustürschlüssel für NFC- und UWB-Schlösser

TSMC plant Investition von bis zu 1 Mrd. Dollar in Anthropic und OpenAI

TC Battlefield: Acecore, Supplya und Navidyn auf den Top-Plätzen