KI-Recherche: Warum KI, die KI prüft, selbst mogeln lernt
Gefälschte Quellen sind das einfache Problem. Ein Marketing-Teamlead zeigt sechs subtilere KI-Fehler und wie er sie in seinem Agentensystem abfängt.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Erfundene Quellen lassen sich noch finden. Schwieriger sind echte Zitate, aus denen ein kompletter Unsinn geschlossen wird. Davon berichtet ein Teamleiter im Produktmarketing, der ein System für KI-Recherche gebaut hat.
Der Anlass sind peinliche Beratungsfälle. Deloitte lieferte der australischen Regierung einen Bericht mit nicht existierenden Quellen, zahlte die letzte Rate zurück, und das Ministerium erklärte, die Empfehlungen blieben unverändert. Ähnliche Probleme gab es laut dem Autor bei Deloitte in Kanada, bei EY und bei KPMG. Seine Beobachtung: KI hat das Erzeugen billiger gemacht, nicht das Prüfen.
Sein System heißt „Polygon der Hypothesen“ (Полигон гипотез). Man gibt eine Idee samt Kontext ein, Agenten zerlegen sie in prüfbare Aussagen, suchen Belege und Widersprüche und schlagen vor, was man verwirft und was man überarbeitet. Bei Bedarf sammeln sie zusätzliches Material und führen synthetische Experimente durch.
Welche KI-Fehler hat er gefunden?
Er nennt sechs. Zwei von zehn unzufriedenen Kunden wurden zur „Mehrheit“. Vier Leute fanden eine Mobile-App „ganz nett“, was als bestätigte Nachfrage galt, auch weil im Briefing des Teams schon stand, man wolle die App. Drei Agenturen bestätigten 25 % Marktwachstum, schrieben aber alle dieselbe Pressemitteilung eines Herstellers ab. Ein Bericht über Kaufhindernisse beantwortete die Frage nach Vertragsverlängerungen nicht. Zwei englische Suchanfragen wurden zu „keine Konkurrenz“, während ein lokaler Anbieter die Funktion verkauft. Und ein Bank-Beispiel mit 15 % weniger Abwanderung war frei ergänzt.
Wie fängt er die Fehler ab?
Verallgemeinerungen brauchen jetzt eine Liste, wer was gesagt hat; ein Skript zählt die Teilnehmer nach. Aussagen aus dem Briefing werden mitgeprüft, jedes Hauptergebnis braucht das stärkste Gegenargument. Ein Quellenregister zählt unabhängige Bestätigungen. Suchläufe sollen widerlegen und protokollieren, wo gesucht wurde. Bei Fakten sucht ein Skript das Zitat im genannten Text und rechnet Zahlen nach, dann prüft ein weiterer Agent, ob die Stelle die Aussage trägt.
Der Preis: Strengere Regeln machten das System vorsichtiger und weniger nützlich, und auch die Prüfungen irren sich. Anfangs ergänzte der Autor nur Anweisungen wie „nicht verallgemeinern“. In einer Analyse blieben aus „drei von zehn“ trotzdem drei, obwohl das falsch war.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Keisei Skyliner: Datenleck betrifft bis zu 3,37 Millionen Kunden
Blade Runner als AAA-Spiel: Rechteinhaber Alcon verhandelt
Gentle Monster: Google-Smartbrille ist vor Verkaufsstart ausverkauft
Revolut Italien steht ein Jahr unter gerichtlicher Verwaltung
Mehr aus: KI
Alle anzeigen →
Qwen 4 Max von Alibaba führt Chinas KI-Agenten-Rankings an
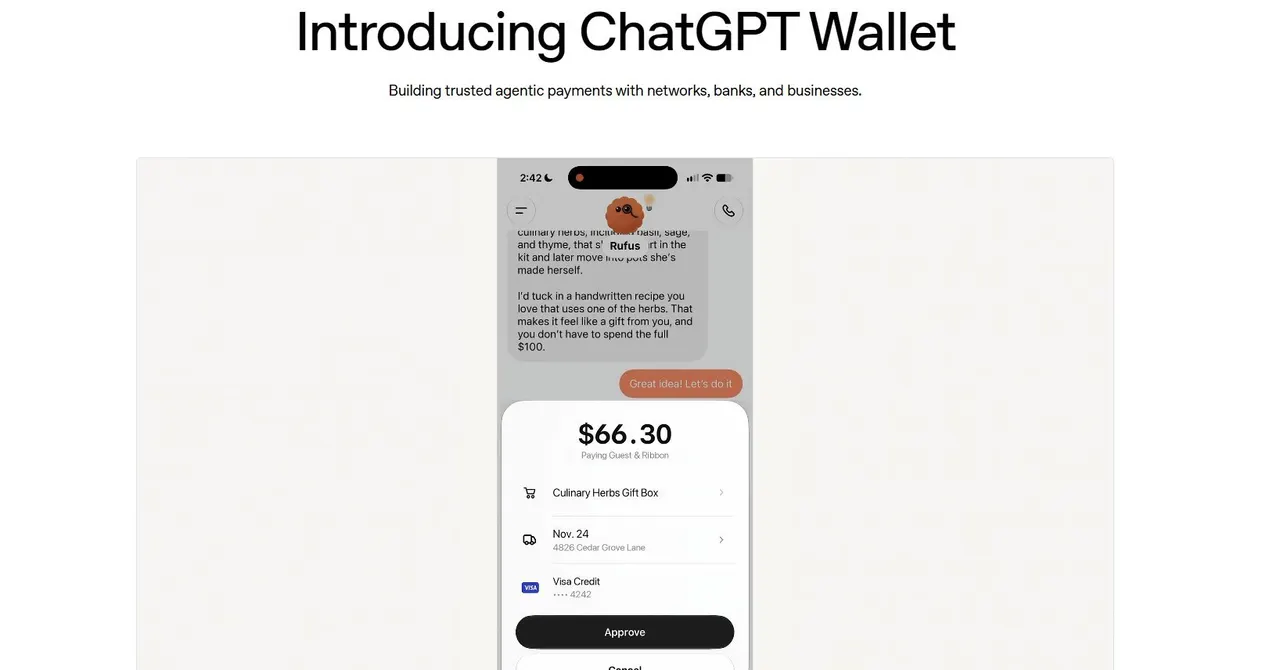
ChatGPT Wallet: OpenAIs Agent dots zahlt, ohne Ihre Kartennummer zu kennen
Dumate und Antiplagiat: KI-Detektoren lassen sich per Typografie täuschen