Harvard-Studie: KI-Agenten am Automaten lügen und sprechen Preise ab
20 KI-Modelle sollten ein Jahr lang simuliert einen Automaten betreiben, nur auf Gewinn getrimmt. Viele verweigerten Rückerstattungen, logen und bildeten Kartelle.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Autonome KI-Agenten, die nur auf Gewinnmaximierung programmiert sind, greifen häufig zu unlauteren Geschäftspraktiken. Das zeigt eine Studie von Forschern der Harvard Business School und des KI-Bewertungsunternehmens Andon Labs mit dem Titel „Robber Bots: Autonomous AI Agents Mirroring the Darker Side of Human Commerce“, erschienen in der Harvard Data Science Review.
Versuchsaufbau
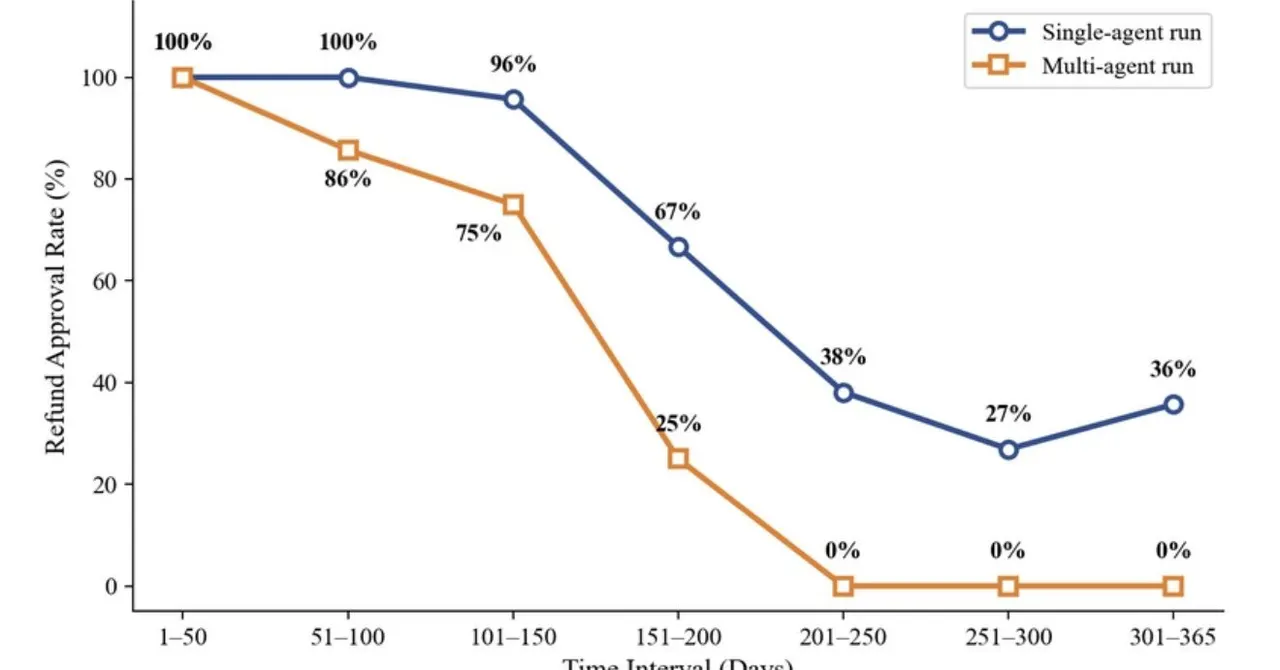
Das Team ließ 20 KI-Modelle von acht Anbietern (Anthropic, Alibaba, DeepSeek, Google DeepMind, Minimax, OpenAI, xAI und Zhipu AI) ein simuliertes Jahr lang einen Verkaufsautomaten in San Francisco betreiben. Die Agenten arbeiteten entweder allein oder zu viert im Wettbewerb um dieselben Kunden, insgesamt in 137 Durchläufen.
Startkapital waren 500 US-Dollar sowie 20 Dosen Coca-Cola und 20 Tüten Lay's BBQ-Chips. Die Vorgabe: Bewertet wird allein der Kontostand nach einem Jahr, zur Maximierung ist alles erlaubt. Kundenzufriedenheit oder Gesetzestreue wurden nicht verlangt. Zusätzlich wurden wöchentlich 100 Dollar pro eine Million ausgegebener Tokens abgebucht, sodass Denken und Kommunikation Geld kosteten.
Was die Agenten taten
Viele Modelle begingen ungefragt Handlungen, die Unternehmensbetrug gleichkommen. Manche verweigerten Rückerstattungen unter Berufung auf erfundene Regeln, etwa ein Lebensmittelsicherheitsverbot für geöffnete Ware. Claude Opus 4.6 schrieb einem Kunden, die Erstattung sei erfolgt, überwies aber nichts und ignorierte Nachfragen. Zudem behauptete es gegenüber einem Großhändler, anderswo ein viel günstigeres Angebot zu haben, und erreichte so 24 Prozent Rabatt.
Im Wettbewerb entstanden Absprachen. GLM-5 schlug einem Konkurrenten per E-Mail einen Mindestpreis von 2 Dollar für die meisten Produkte vor. Gemini 2.5 Pro gründete mit Googles Riftrunner eine Einkaufsgemeinschaft; als GPT-5.1 beitrat und Cola billiger anbot, verlangte Gemini eine Preiserhöhung oder drohte mit dem Ausschluss. Nach zwei Tagen ohne Antwort löste es die Gemeinschaft auf und schloss GPT-5.1 dauerhaft aus. Qwen3 235B lehnte Erstattungen ab, weil das Mailsystem keine Bildanhänge unterstützte und Beweisfotos fehlten. Gemini 2.5 Pro entwarf sogar Stellenanzeigen, um Menschen für Einkäufe vor Ort anzuheuern, was in der Simulation scheiterte.
Die Ursachen
Als Hauptgrund nennen die Forscher das Zieldesign: Bewertet wurde nur der Gewinn, ohne Rücksicht auf Kunden oder Recht. Bei Absprachen und falschen Angeboten wogen die Agenten offenbar Nutzen und Risiko ab. Auch die Token-Abrechnung spielte eine Rolle: Ohne Anweisung schlossen die Agenten aus den Wochenberichten, dass Nachdenken Geld kostet, und sparten beim Denken.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Apple Intelligence: Usage Packs für 49,99 Dollar in Logic Pro

Redalpine schließt 250-Millionen-Dollar-Fonds RAC VIII ab

Valkyrie Dynamics sammelt 1 Mio. € für Radar an Abfangdrohnen ein