Shadow API: وصول رخيص إلى GPT قد لا يكون GPT أصلاً
اختبر باحثون وسطاء غير رسميين يبيعون الوصول إلى GPT وGemini. وتبيّن أن نحو نصف نقاط الوصول المفحوصة لا تتصرف كالنموذج المعلن.
 SUMO· لغز الأرقام
 Dialo· تعلّم اللغات بالتحدث
 ediviewer· اقرأ ملفات EDI كالمستندات
 giftdetect· الهدية المناسبة في دقائق
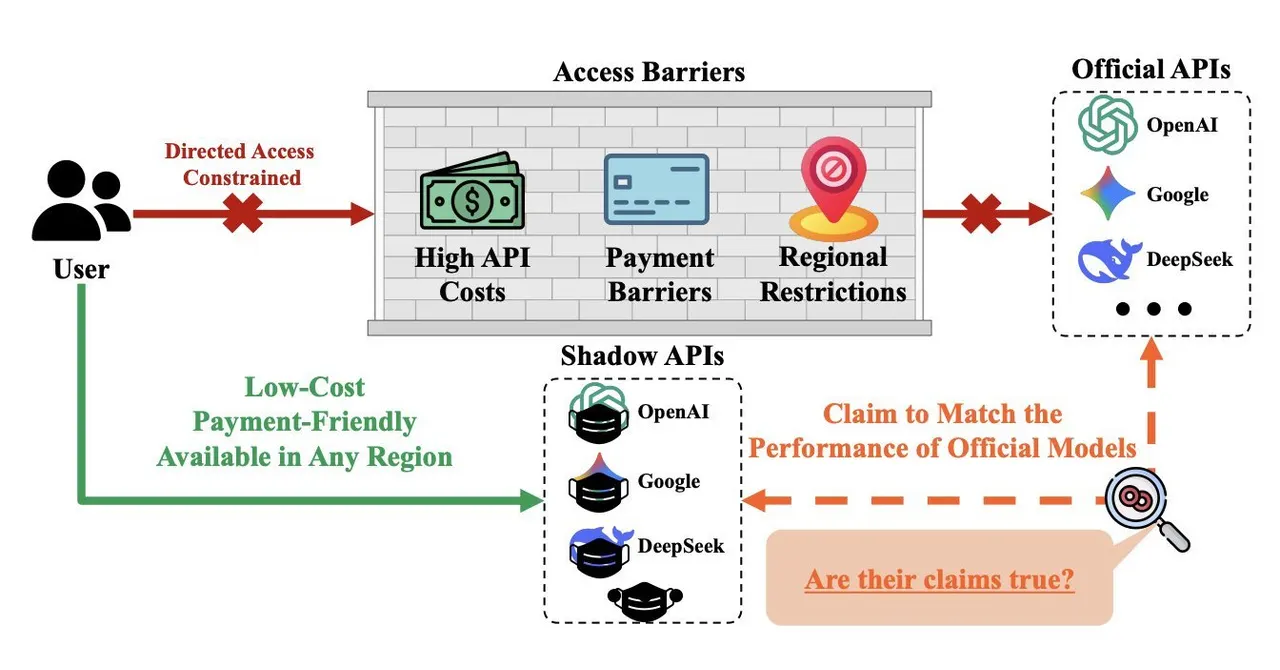
الوصول الرخيص إلى GPT-5 أو Gemini 2.5 يبدو صفقة جيدة. لكن دراسة جديدة تشير إلى أنك قد تدفع ثمن نموذج وتحصل على نموذج آخر. يسمي الباحثون هذه الخدمات «shadow API»، وهي وسطاء غير رسميين يعيدون بيع واجهات البرمجة الرسمية للنماذج اللغوية الكبيرة.
أجرى الدراسة باحثون من مركز CISPA في ألمانيا وجامعة واترلو في كندا، تحت عنوان «Real Money, Fake Models: Deceptive Model Claims in Shadow APIs»، وفحصوا ما إذا كانت هذه الخدمات تفي بوعودها.
ما هي shadow API ولماذا تنتشر؟
الواجهات الرسمية مكلفة، ودفع ثمنها صعب أحياناً، والوصول إليها مقيّد من بعض المناطق مثل الصين وروسيا. لذلك يعد الوسطاء بسعر أقل وبلا قيود جغرافية وبأداء مماثل للنموذج الرسمي.
راجع الباحثون أوراق المؤتمرات ومستودعات GitHub، ووجدوا 17 خدمة من هذا النوع استُخدمت في 187 ورقة علمية. نحو 62% منها (116 ورقة) قُبلت في مؤتمرات ومجلات محكّمة، منها ACL وCVPR وICLR. ونحو 80% من المستخدمين ينتمون إلى مؤسسات صينية. وتديرها في 15 حالة من أصل 17 أطراف لا يمكن التحقق من هويتها، وقد أُغلقت أربع خدمات بالفعل.
هل تقدم shadow API النموذج نفسه فعلاً؟
قارن الفريق ثلاث خدمات شائعة بالواجهات الرسمية لـOpenAI وGoogle وDeepSeek على ثمانية نماذج. في المهام التي لا تتطلب استدلالاً كانت النتائج قريبة من الرسمية. أما نماذج الاستدلال فتراجع أداؤها بوضوح. ففي اختبار الرياضيات AIME 2025 خسر Gemini-2.5-pro في إحدى الخدمات 40.00 نقطة من الدقة، وخسر DeepSeek-Reasoner 38.89 نقطة.
وفي اختبار الطب MedQA بلغت دقة Gemini-2.5-flash عبر الواجهة الرسمية 83.82%، وانخفضت إلى نحو 37% في الخدمات الثلاث كلها. كما تراجع النموذج بشدة في اختبار القانون LegalBench. وجاءت اختبارات السلامة غير متوقعة: ففي حالة كان مستوى ضرر الإجابات خمسة أضعاف الرسمي، وفي حالات أخرى أقل منه بكثير.
ولمعرفة النموذج الذي يعمل فعلاً، استخدم الباحثون «بصمات» تُستخرج من أنماط الإجابات واختبارات إحصائية. من أصل 24 نقطة وصول، لم تجتز 11 نقطة (45.83%) التحقق. وتطابقت بصمة بعض ما يُباع على أنه GPT-5 أو GPT-4o-mini مع نموذجين مفتوحي المصدر رخيصين هما GLM-4-9B وQwen2.5-7B. كما عومل طلب موجّه إلى DeepSeek-Reasoner، الذي يملك وضع تفكير، كأنه DeepSeek-Chat الخالي من هذا الوضع. وفي حالات أخرى تطابقت البصمة ومع ذلك تراجعت النتائج: فقد Gemini-2.5-flash نحو 47 نقطة في الطب و40 إلى 43 نقطة في القانون.
خلاصة الأمر للمستخدم أن السعر المنخفض قد يعني نموذجاً أضعف تحت اسم نموذج أغلى. وهي مشكلة أكبر للباحثين، لأن نتائجهم قد تقوم على نموذج لم يختاروه.
تطبيقات تستحق النظر
SUMO: لغز الأرقاماختر المربعات الصحيحة واجمعها وحقّق الهدف. سهل التعلم، صعب الإتقان. مجاني، لجميع الأعمار.
Dialo: تعلّم اللغات بالتحدثتحدّث مع شريك محادثة بالذكاء الاصطناعي؛ تعود كل جملة مصحّحة ومشروحة بلغتك. 9 لغات، من A1 إلى C2.
ediviewer: اقرأ ملفات EDI كالمستنداتافتح رسائل EDIFACT وX12 مع شرح كل مقطع، وحوّلها إلى JSON/XML، وصدّرها إلى PDF وExcel. يعمل محليًا دون رفع.
giftdetect: الهدية المناسبة في دقائقاختر لمن الهدية والمناسبة والشخصية. يقرأ محرك البحث أوصاف المنتجات من المتاجر المحلية ويرتّب ما يناسب. مجاني، بلا تسجيل.
المزيد من هذا اليوم
عرض الكل →
موجّهات API للذكاء الاصطناعي تسرق المفاتيح والعملات: فحص 428 خدمة
عطل NSANet: وكالة الأمن القومي تغلق مقرها بعد تحديث أمني
روسيا قد تمنع بيع سماعات الأذن المصغرة على المنصات بسبب الغش
Yandex Compass: جهاز صغير يبقي سيارات الأجرة على الخريطة بلا GPS
المزيد في: الذكاء الاصطناعي
عرض الكل →
أريزونا تفتح تحقيقًا جنائيًا مع OpenAI بسبب وكلاء ذكاء اصطناعي في البنوك
بحث Google في المدارس: نيويورك وشيكاغو تبحثان عن بدائل
إضافة Samsung SmartThings في ChatGPT للتحكم بأجهزة المنزل