Nous Research تعيد تدريب نموذج Qwen الصيني وتطلق Arete-27B
أطلقت Nous Research نموذج Arete-27B المعاد تدريبه من Qwen3.8-27B، وتقول اختبارات الشركة إن الإجابات المرددة لخطاب الحكومة الصينية انخفضت من 22% إلى 0.9%.
 SUMO· لغز الأرقام
 Dialo· تعلّم اللغات بالتحدث
 ediviewer· اقرأ ملفات EDI كالمستندات
 giftdetect· الهدية المناسبة في دقائق
كشفت شركة Nous Research، المتخصصة في نماذج الذكاء الاصطناعي مفتوحة المصدر، عن Arete-27B، وهو نسخة معاد تدريبها من نموذج Qwen3.8-27B الذي طورته علي بابا. وتقول الشركة إن هدفها «تعزيز القيم الغربية» في نموذج صيني المنشأ.
لم يُبنَ نموذج أساسي جديد من الصفر، بل أجرت الشركة تدريبًا إضافيًا على نحو 52.8 مليون رمز (token). مُرّر مجموع البيانات على النموذج مرتين، بإجمالي 1202 خطوة تدريب. ولم تُستخدم تقنيات التعلم المعزز أو تحسين التفضيلات، ولم تتغير البنية. وجُمّد المشفّر البصري لأن البيانات نصية.
نتائج من تقييم أعدّته الشركة
أعدّت الشركة 803 أسئلة في سبع فئات، منها حرية التعبير وأيديولوجيا الدولة والسوق الحرة والتعليم وخصوصية البيانات والمراقبة والديمقراطية والبيئة. قُيّمت الإجابات من حيث المعلومات المقدمة ومن حيث تبنّي النموذج للخطاب الرسمي للحكومة الصينية. وبحسب الاختبارات، بلغت نسبة هذه الإجابات 22% في Qwen3.8-27B وانخفضت إلى 0.9% في Arete-27B. كما ارتفع مؤشر «fact score» من 2.32 إلى 2.98 من 5.
وكان التغير الأكبر في فئة حرية التعبير: ارتفعت درجة المعلومات من 0.89 إلى 2.44، وتراجعت نسبة الإجابات المتبنية للخطاب الرسمي من 60% إلى 1%.
غير أن هذه النتائج صادرة عن نظام تقييم وضعته Nous Research نفسها. فقد استخدمت Grok 4.7 لتصحيح الإجابات، ولم يراجع البشر سوى عينة من 25 سؤالًا. ولم يتحقق طرف مستقل من النتائج بعد، كما أن انخفاض نسبة الخطاب الرسمي لا يعني زوال كل التحيزات السياسية.
أداء عام شبه ثابت
في اختبار Hermes Bench الداخلي سجّل Qwen3.8-27B نسبة 65.77% مقابل 65.60% لـ Arete-27B، وتعدّ الشركة فارق 0.17 نقطة ضمن هامش القياس. وفي Terminal-Bench-2.1 الذي يقيس إنجاز وكلاء الذكاء الاصطناعي للمهام، حقق Arete-27B نسبة 70% مقابل 67% للنموذج الأساسي، لكن الشركة لا تنسب هذا الفارق إلى أسلوبها بسبب اختلاف إعدادات الاختبار.
واستُخدم النموذج Inkling معلّمًا، إذ أُنشئت نحو 20 ألف مطالبة أنتجت مجموعة من 28,886 مثال تدريب. ونشرت الشركة أوزان النموذج وبيانات التدريب ومجموعة التقييم على Hugging Face ليتمكن الباحثون من اختبار النتائج باستقلالية. وترى Nous Research أن القيم المضمّنة في النماذج مفتوحة الأوزان يمكن تغييرها بشكل كبير بتدريب إضافي محدود نسبيًا.
تطبيقات تستحق النظر
SUMO: لغز الأرقاماختر المربعات الصحيحة واجمعها وحقّق الهدف. سهل التعلم، صعب الإتقان. مجاني، لجميع الأعمار.
Dialo: تعلّم اللغات بالتحدثتحدّث مع شريك محادثة بالذكاء الاصطناعي؛ تعود كل جملة مصحّحة ومشروحة بلغتك. 9 لغات، من A1 إلى C2.
ediviewer: اقرأ ملفات EDI كالمستنداتافتح رسائل EDIFACT وX12 مع شرح كل مقطع، وحوّلها إلى JSON/XML، وصدّرها إلى PDF وExcel. يعمل محليًا دون رفع.
giftdetect: الهدية المناسبة في دقائقاختر لمن الهدية والمناسبة والشخصية. يقرأ محرك البحث أوصاف المنتجات من المتاجر المحلية ويرتّب ما يناسب. مجاني، بلا تسجيل.
المزيد من هذا اليوم
عرض الكل →
آبل تطرح Intelligence Usage Packs في Logic Pro بسعر 49.99 دولارًا

Redalpine تغلق صندوق RAC VIII بقيمة 250 مليون دولار

Valkyrie Dynamics تجمع مليون يورو لرادار الطائرات المسيّرة الاعتراضية

ريد هات تطلق OpenShift 5 بأدوات ذكاء اصطناعي لاستكشاف الأعطال
المزيد في: الذكاء الاصطناعي
عرض الكل →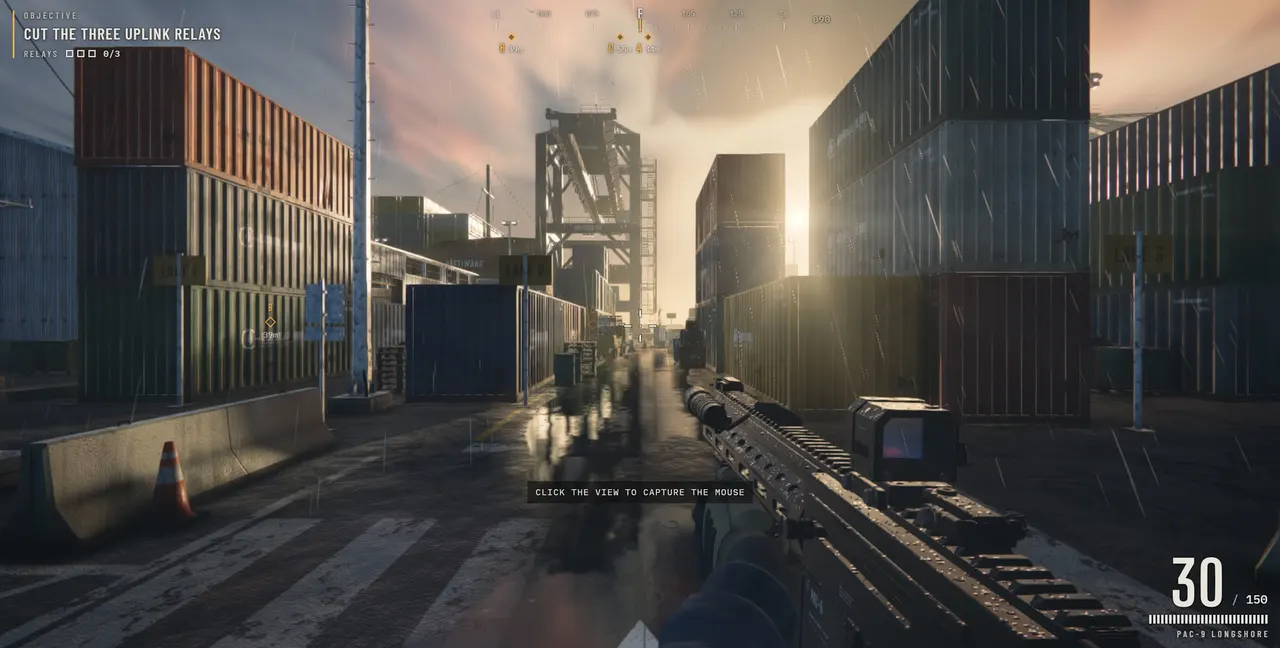
Claude Fable 5.2 يبني لعبة FPS ثلاثية الأبعاد كاملة في 8 ساعات بطلب واحد
PwC: مدير متجر بالذكاء الاصطناعي يفشل مع الموظفين ويخسر 244 ألف ين
أليكسا+ من أمازون تعمل في ألمانيا عبر المتصفح على Alexa.com