Tesseract 5 Mansi diline uyarlandı, OCR hataları 20 kat azaldı
Rus araştırmacılar açık kaynaklı Tesseract 5'i Mansi dili baskı metinleri için eğitti. Hatalı karakter oranı %18,5'ten %0,85'e düştü; model Hugging Face'te ücretsiz.
Югорский НИИ информационных технологий (ЮНИИИТ), açık kaynaklı OCR motoru Tesseract 5'i Mansi dilindeki basılı metinleri okuyacak şekilde yeniden eğitti. Ekibe göre hatalı karakter oranı %18,5'ten %0,85'e geriledi; bu, yaklaşık 20 kat daha az hata demek. Model Hugging Face üzerinde ücretsiz olarak kullanılabiliyor.
Standart OCR neden yetersiz kalıyor
Mansi yazısı Kiril alfabesine dayanıyor, ancak kendine özgü harfler içeriyor: а̄, о̄, ӯ, э̄ ve ы̄ gibi makronlu uzun ünlüler ile “ng” sesini gösteren ӈ harfi. Mansi dilinde ünlü uzunluğu anlam taşıdığından makronun kaybı sözcüğü değiştirebiliyor. Tesseract'ın standart Rusça modeli bu karakterleri tanımıyor; harfin üzerindeki çizgiyi kaçırıyor, bazen de harfi anlamsız bir karaktere çeviriyor. Mansi metinlerinde her 100 karakterin yaklaşık 18'inde hata yapıyor.
İkinci sorun Unicode kaynaklı: makronlu aynı harf farklı biçimlerde kodlanabiliyor. İnsan gözüne aynı görünen bu diziler model için farklı.
Tarama yerine sentetik veri
Elde yeterli büyüklükte Mansi tarama arşivi yok, elle etiketleme ise yıllar sürerdi. Ekip bu yüzden veriyi kendisi üretti. Basılı ve elektronik yayınlardaki gerçek metinler Unicode NFC biçimine normalleştirildi, Python betikleriyle görüntüye dönüştürüldü. Aralarında FreeSerif, DejaVu Sans, Arial, Calibri ve Times New Roman'ın da bulunduğu onlarca yazı tipi; 12, 14, 24 ve 26 punto boyutları; normal, kalın ve italik stiller kullanıldı.
Her karakter box dosyalarında kutuyla işaretlendi. Otomatik hesaplamalar satırın üzerine taşan makronu sık sık yanlış yakaladığı için ekip CHAR_OFFSETS, CHAR_SIZE ve RATE adlı üç sözlükle piksel düzeyinde düzeltmeler yaptı. Sonuçta .tif biçiminde satır görüntüsü ve doğru metni içeren .gt.txt dosyasından oluşan 1,3 milyon çift üretildi.
Temel model olarak tessdata_best deposundaki resmi rus.traineddata alındı; Mansi alfabesi büyük ölçüde Rusçayla örtüştüğü için ağın esas olarak yeni harfleri öğrenmesi gerekiyor. Proje, daha önce 300 bin paralel cümlelik bir derlem ve Rusça-Mansi çeviri modeli üretmişti. OCR, çoğu hâlâ yalnızca kâğıtta duran kitap, ders kitabı, folklor derlemesi ve gazete arşivlerinin dijitalleştirilmesini hedefliyor.
Göz atmaya değer uygulamalar
 SUMO: sayı bulmacası
Doğru kareleri seçin, toplayın, hedefe ulaşın. Öğrenmesi kolay, ustalaşması zor. Ücretsiz, her yaşa uygun.
 Dialo: konuşarak dil öğrenin
Yapay zekâ sohbet partneriyle konuşun; her cümleniz düzeltilip kendi dilinizde açıklanarak geri gelsin. 9 dil, A1'den C2'ye.
 ediviewer: EDI dosyalarını belge gibi okuyun
EDIFACT ve X12 mesajlarını açın, her segment açıklansın, JSON/XML'e çevirin, PDF ve Excel'e aktarın. Yerelde çalışır, yükleme yok.
Aynı günden diğer haberler
Tümünü gör →
CyberKord, BT ve siber güvenlik otomasyonu için 2,7 milyon avro topladı
Nvidia destekli Cohere, Singapur'da savunma yapay zekâsı hızlandırıcısı başlattı
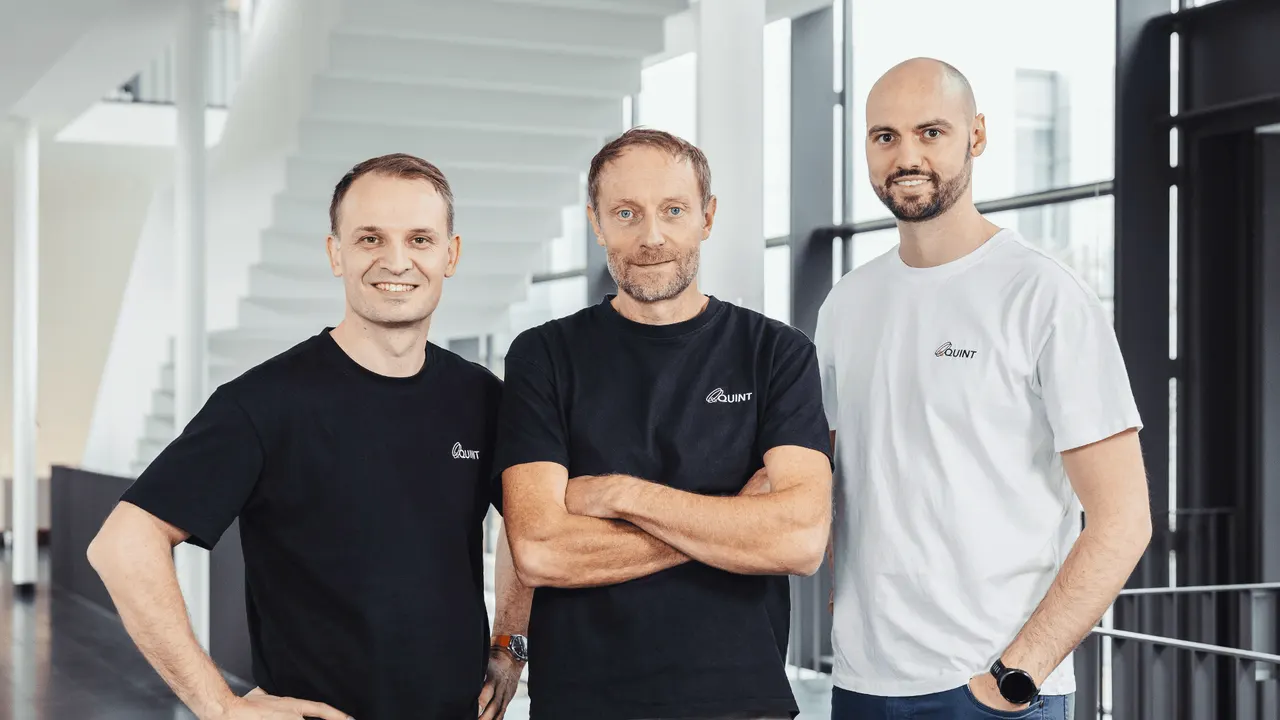
Quint Computing, kuantum çiplerinde hata oranını düşürmek için 9,1 milyon euro topladı
Hypersonica, Lightspeed ve General Catalyst'ten 100 milyon euro aldı
Daha fazla: Yapay zekâ
Tümünü gör →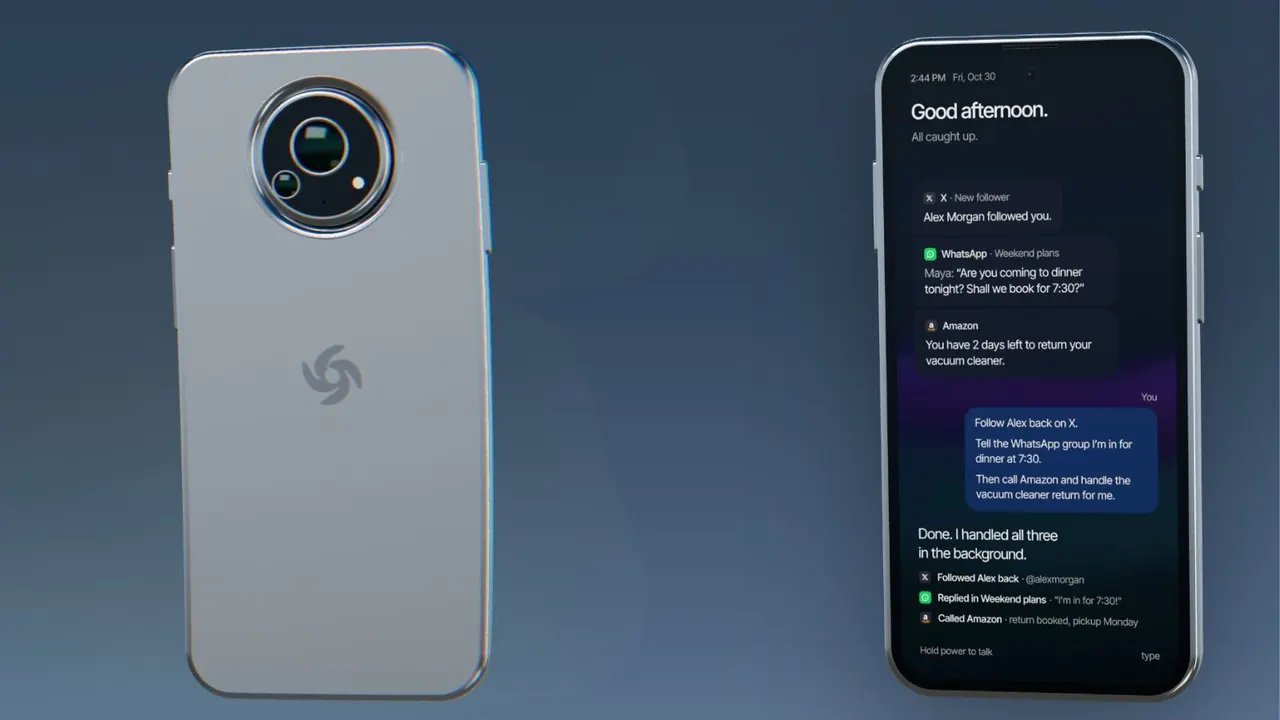
Cyclon, Pixel 8a tabanlı 699 dolarlık yapay zekâ telefonunun ön siparişini açtı
OpenAI, ChatGPT Pro ve Business Premium kullanım limitlerini ikiye katladı
Upstage, Solar Pro 4'ü Güney Kore'nin kamu yapay zekâ altyapısına taşıdı