Takeout X-Ray: analiza archiwów 500 MB z Telegrama w przeglądarce
Takeout X-Ray to darmowa aplikacja webowa, która analizuje ogromne eksporty z Telegrama, ChatGPT, Spotify i Chrome w karcie przeglądarki. Nic nie trafia na serwer.
 SUMO· łamigłówka liczbowa
 Dialo· ucz się języków, mówiąc
 ediviewer· czytaj pliki EDI jak dokumenty
 giftdetect· trafiony prezent w kilka minut
Autor chciał sobie zrobić „Spotify Wrapped”, tylko dla starych rozmów z Telegrama, dialogów z ChatGPT i historii przeglądarki. Tak powstał Takeout X-Ray, statyczna aplikacja webowa, która analizuje wielogigabajtowe archiwa w całości na twoim komputerze. Bez backendu i bez wysyłania czegokolwiek w sieć.
Założenia były dwa. Po pierwsze, żadnego serwera: wgrywanie gigabajtów prywatnych rozmów, zapytań i promptów obcej firmie wygląda podejrzanie, nawet jeśli przy okazji dostaniemy zapewnienie, że „niczego nie przechowujemy”. Po drugie, żadnego await file.text() z następującym po nim JSON.parse(). Pełny eksport konta z Telegrama albo archiwum Google Takeout łatwo waży 300–700 MB i zawiera setki tysięcy obiektów. Załadowanie takiego JSON-a jako jednego napisu kończy się brakiem pamięci i zawieszeniem karty.
W wersji 2.0 narzędzie obsługuje 12 usług i 13 formatów eksportu: Telegram, WhatsApp, Discord, X (Twitter), Spotify, YouTube, TikTok, Chrome, ChatGPT, Claude.ai oraz lokalne logi agentów AI, czyli Claude Code CLI i Antigravity. Pod spodem działa DuckDB-Wasm (baza SQL uruchamiana w przeglądarce), osobny Web Worker i parsery strumieniowe. Jest też piaskownica SQL i demo z syntetycznymi danymi.
Jak Takeout X-Ray radzi sobie z wielkimi plikami .zip?
Gdy wybierzesz archiwum, aplikacja czyta tylko spis treści na końcu pliku (central directory). Zdjęcia, filmy i stickery, które potrafią zajmować kilka gigabajtów, nie są nawet odczytywane. Jeśli w jednym Takeoucie jest kilka usług, np. historia Chrome i YouTube, program prosi o wybór, zamiast mieszać dane. Wybrany plik trafia do parsera strumieniowo, w kawałkach po 64 KB.
Rodzaj eksportu rozpoznawany jest po pierwszych bajtach, w oknie rosnącym od 64 KB przez 512 KB do 4 MB. Okazało się to potrzebne: w pełnym eksporcie z Telegrama przed kluczem chats.list bywa ponad 80 KB metadanych kontaktów. Dane z parsera SAX trafiają do DuckDB paczkami po 5 000 wierszy, a tymczasowe pliki są zawsze usuwane, inaczej pamięć w module Wasm rosłaby razem z rozmiarem pliku.
Dziwactwa prawdziwych eksportów
W ChatGPT wiadomości leżą w grafie skierowanym, nie na płaskiej liście. Regenerowane odpowiedzi i edytowane prompty zostają w nim jako boczne gałęzie, więc parser idzie od węzła current_node w górę i odtwarza aktywną rozmowę. Różnica względem całego grafu pokazuje, ile razy kazałeś AI odpowiadać od nowa. Archiwum X to z kolei nie JSON, a pliki JavaScript z przedrostkiem window.YTD.tweets.part0 = .
Aplikacje warte uwagi
SUMO: łamigłówka liczbowaWybierz właściwe pola, dodaj je i trafiaj w cel. Łatwa do nauczenia, trudna do opanowania. Za darmo, dla każdego wieku.
Dialo: ucz się języków, mówiącRozmawiaj z partnerem AI; każde zdanie wraca poprawione i wyjaśnione w Twoim języku. 9 języków, od A1 do C2.
ediviewer: czytaj pliki EDI jak dokumentyOtwieraj komunikaty EDIFACT i X12, każdy segment objaśniony, konwersja do JSON/XML, eksport PDF i Excel. Działa lokalnie, bez wysyłania.
giftdetect: trafiony prezent w kilka minutWybierz dla kogo, okazję i osobowość. Wyszukiwarka czyta opisy produktów lokalnych sklepów i układa to, co pasuje. Za darmo, bez rejestracji.
Więcej z tego dnia
Zobacz wszystkie →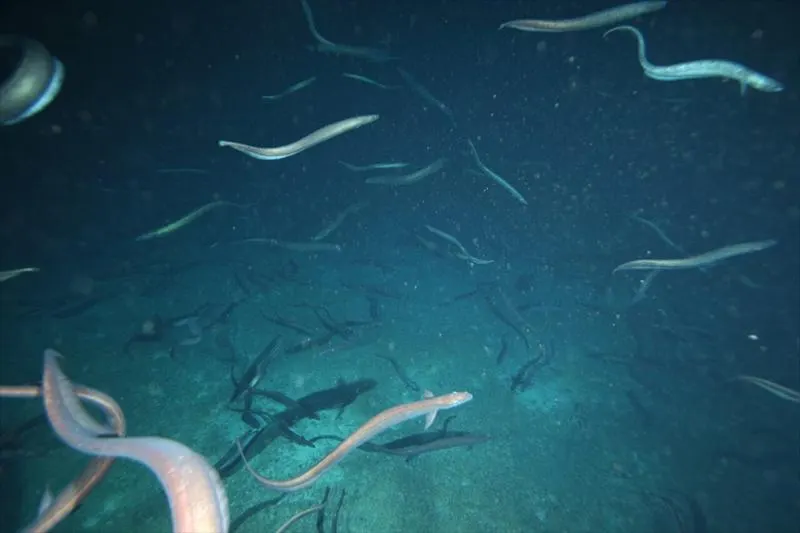
Węgorze basketwork: 2,8 mln sztuk na jednej górze podmorskiej
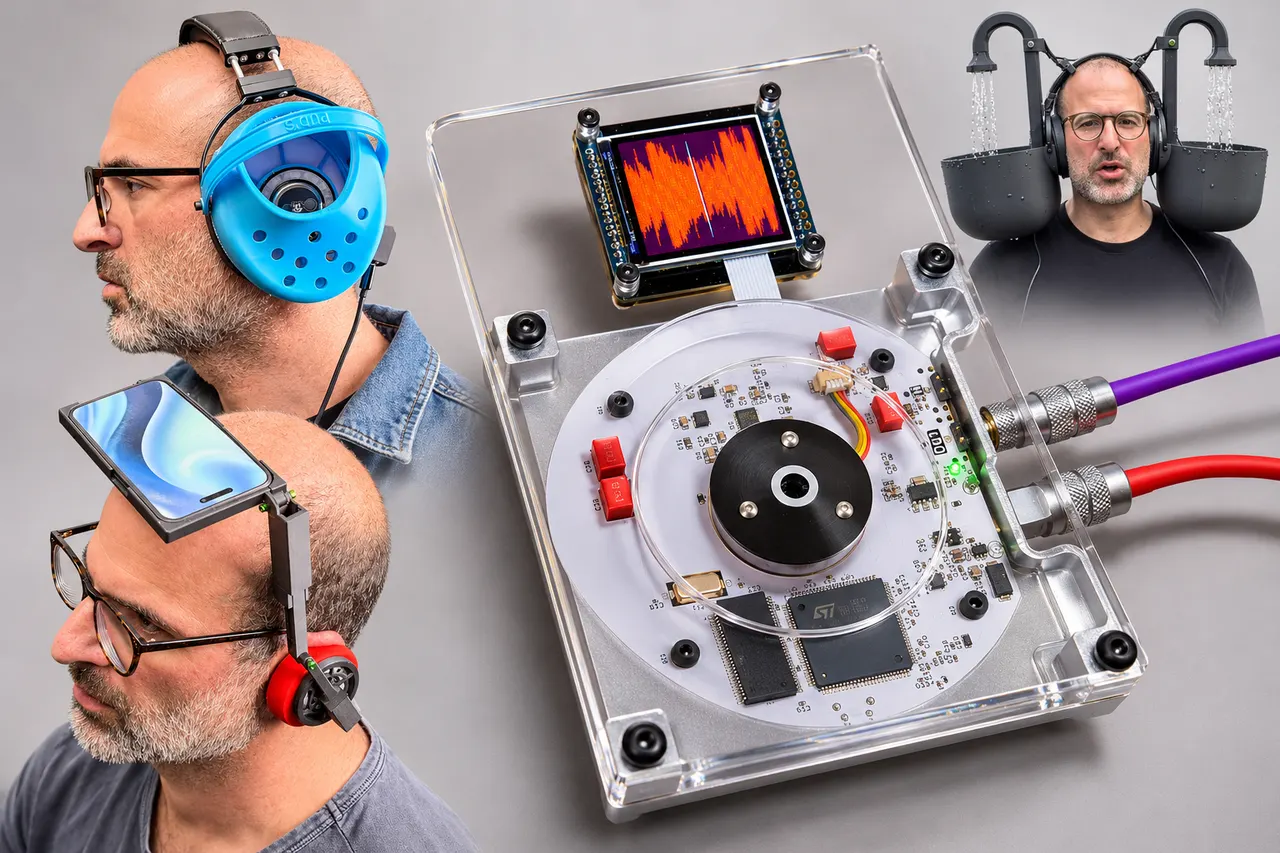
Rotation Station pozwala scratchować Spotify na żywo na DIY
Voyager 1 jest już o jeden dzień świetlny od Ziemi, ale wciąż w domu
Wylsacom ma 30% w Immortal, firmie od bota KloKlo z AI
Więcej w kategorii: Oprogramowanie
Zobacz wszystkie →
Windows UserAssist śledzi każdą aplikację od 2000 roku: jak to wyłączyć
Instagram Content Protection wykrywa skradzione filmy twórców
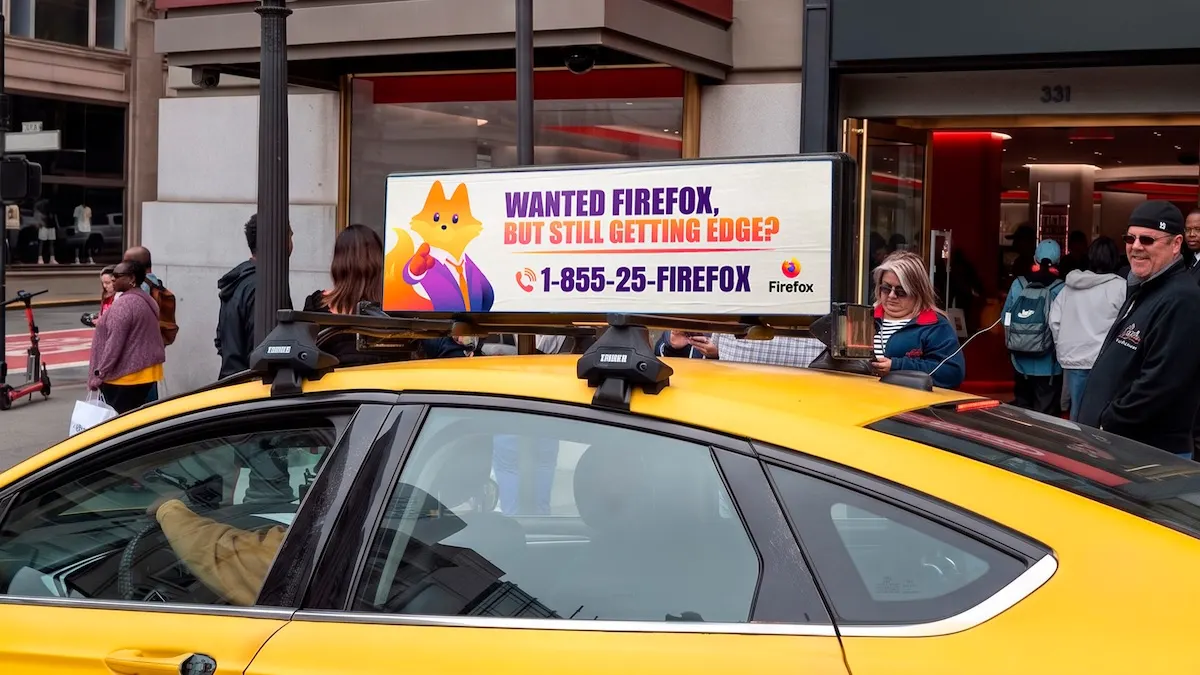
Infolinia Mozilli 1-855-25-FIREFOX dla zmęczonych Edgem