Tesseract 5, 만시어 학습으로 OCR 오류 20분의 1로 감소
러시아 연구진이 오픈소스 Tesseract 5를 만시어 인쇄체에 맞게 미세조정해 문자 오류율을 18.5%에서 0.85%로 낮췄습니다. 모델은 Hugging Face에서 무료 공개됩니다.
러시아 유그라 정보기술연구소(ЮНИИИТ)가 오픈소스 OCR 엔진 Tesseract 5를 만시어 인쇄 텍스트에 맞게 미세조정해 문자 오류율을 18.5%에서 0.85%로 낮췄다고 밝혔습니다. 오류가 약 20분의 1로 줄어든 셈입니다. 모델은 Hugging Face에 공개돼 있으며 바로 사용할 수 있습니다.
기존 모델이 실패한 이유
만시어 표기는 키릴 문자를 기반으로 하지만 а̄, о̄, ӯ, э̄, ы̄ 같은 마크론(글자 위 가로선)이 붙은 장모음과 «ng» 소리를 나타내는 ӈ 같은 고유 문자가 있습니다. 모음 길이가 의미를 가르기 때문에 마크론이 사라지면 다른 단어가 될 수 있습니다. Tesseract의 기본 러시아어 모델은 이 문자들을 알지 못해 마크론을 누락하거나 엉뚱한 문자로 바꿨고, 만시어 텍스트에서 100자 중 약 18자를 틀렸습니다.
마크론이 붙은 같은 글자를 유니코드에서 여러 방식으로 표현할 수 있다는 문제도 있어, 모든 텍스트를 NFC로 정규화했습니다.
합성 데이터로 학습
만시어 도서 스캔본은 거의 없습니다. 연구진은 인쇄물과 전자 자료에서 모은 실제 텍스트를 FreeSerif, DejaVu Sans, Arial, Calibri, Times New Roman 등 수십 종의 글꼴과 12·14·24·26pt 크기, 보통·굵게·기울임 스타일로 이미지화했습니다. 마크론 글자의 경계 상자는 픽셀 단위 보정으로 맞췄습니다. 그 결과 .tif 이미지와 정답 .gt.txt 파일 쌍 130만 개가 만들어졌습니다. 기반 모델은 tessdata_best의 공식 러시아어 모델 rus.traineddata로, 새 문자 학습에 집중하도록 했습니다.
의미
만시어 텍스트 대부분은 아직 책, 교과서, 구전 설화집, 신문 합본 등 종이로만 존재합니다. OCR로 디지털화하면 코퍼스와 번역 모델의 학습 데이터로 쓸 수 있고, 모어 화자의 제한된 시간을 번역과 전문 검수에 쓸 수 있습니다. 이번 발표는 «만시어 코퍼스» 프로젝트 연재의 두 번째 글이며, 첫 번째에서는 병렬 문장 30만 개로 러시아어-만시어 번역 신경망을 학습했습니다.
주목할 만한 앱
 SUMO: 숫자 퍼즐
올바른 칸을 고르고 더해 목표 숫자를 맞추세요. 배우긴 쉽고 마스터하긴 어렵습니다. 무료, 전 연령.
 Dialo: 말하면서 배우는 언어 앱
AI 대화 파트너와 대화하세요. 모든 문장이 교정되어 내 언어로 설명과 함께 돌아옵니다. 9개 언어, A1부터 C2까지.
 ediviewer: EDI 파일을 문서처럼 읽기
EDIFACT와 X12 메시지를 열어 각 세그먼트 설명을 보고, JSON/XML로 변환하고, PDF와 Excel로 내보내세요. 로컬에서 실행, 업로드 없음.
같은 날의 다른 뉴스
전체 보기 →
관련 카테고리: AI
전체 보기 →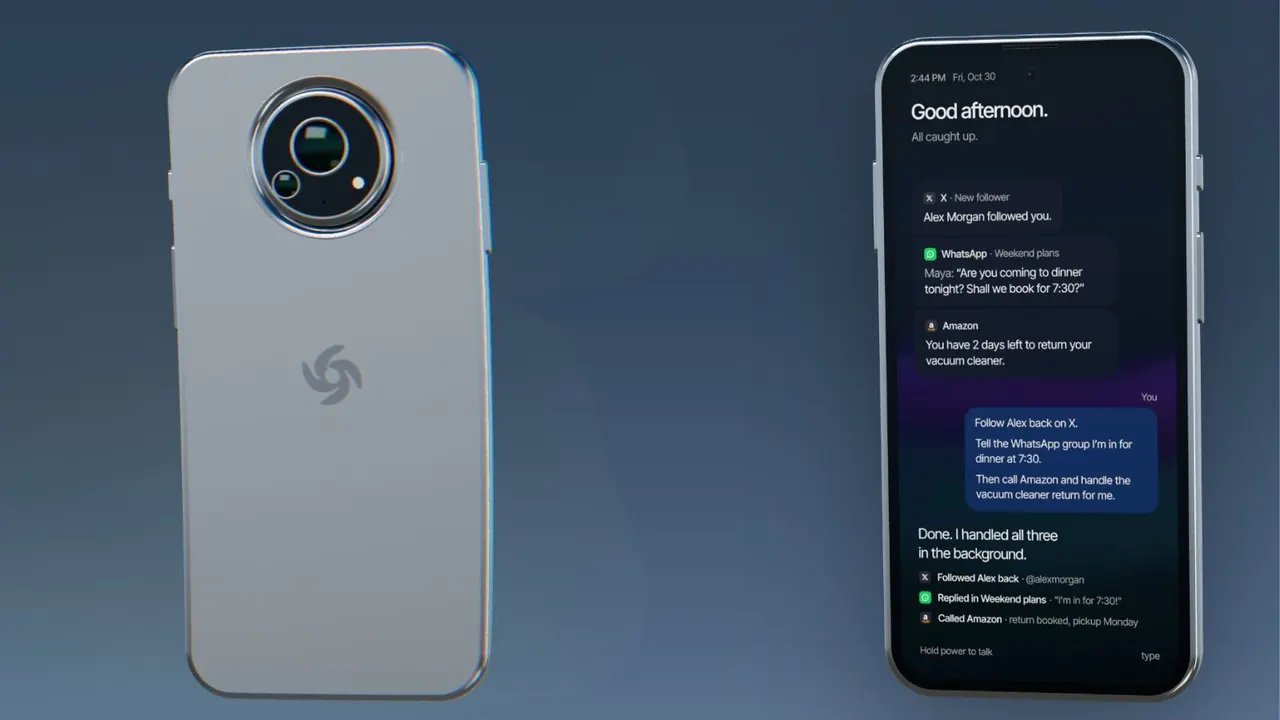
Cyclon, 픽셀 8a 기반 AI 에이전트폰 699달러에 예약 판매
OpenAI, ChatGPT Pro·Business Premium 사용 한도 2배 상향
업스테이지 솔라 프로 4, 범정부 AI 공통기반에 탑재