Windows RDMA über USB4: Mini-PCs teilen Speicher für große KI-Modelle
Microsoft testet eine Windows-Funktion, die Mini-PCs per USB4-Kabel koppelt. So addiert sich der Speicher und ein KI-Modell mit 235 Milliarden Parametern läuft verteilt.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
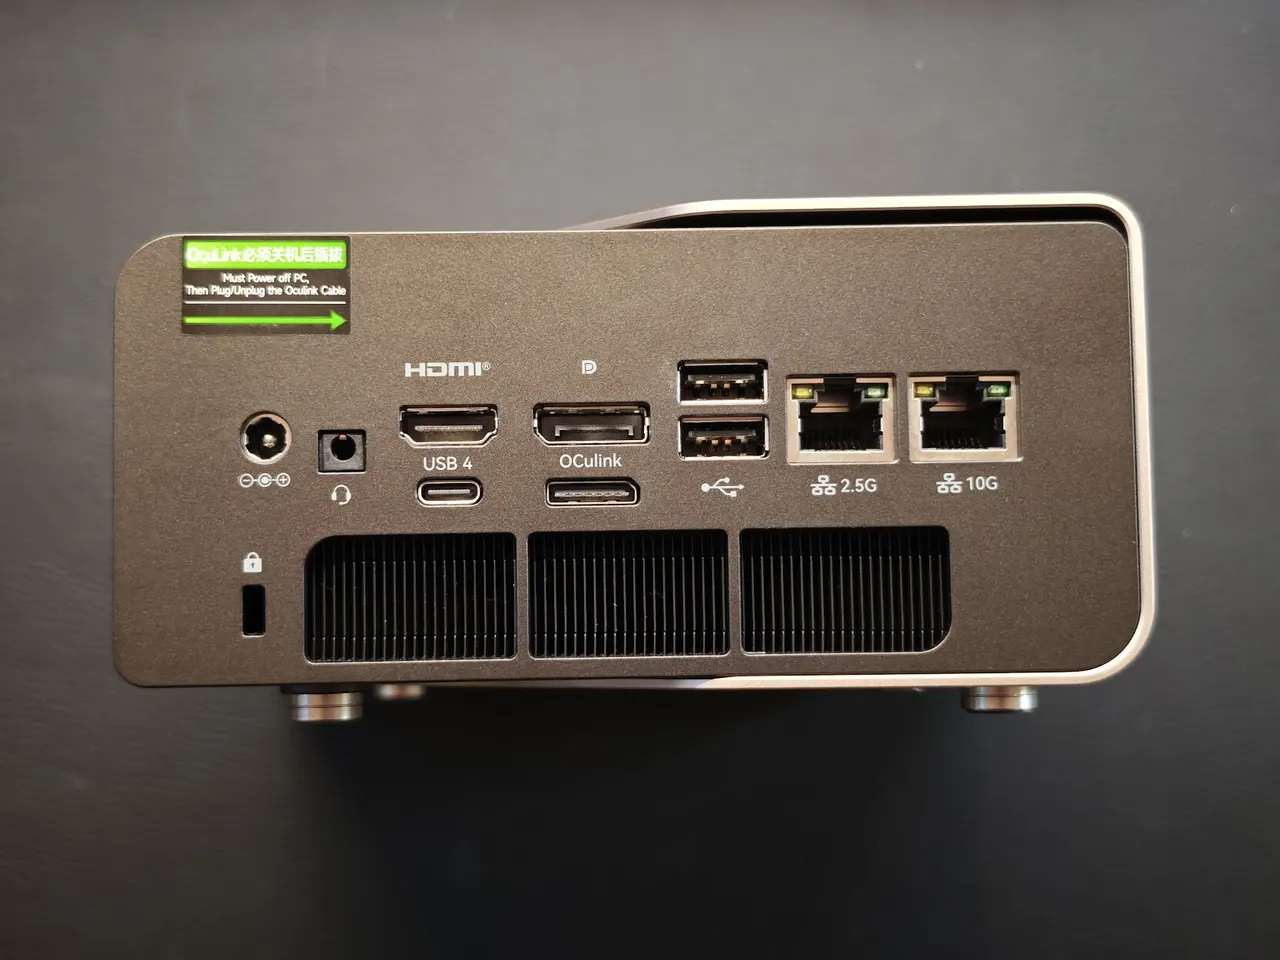
Drei Mini-PCs auf dem Schreibtisch, drei USB4-Kabel dazwischen, und ein KI-Modell mit 235 Milliarden Parametern läuft, als säße es auf einem einzigen Rechner. Das ist die Demo hinter Windows RDMA über USB4, die Microsoft am 19. November als Entwicklervorschau gezeigt hat. Keiner der drei PCs könnte das Modell allein laden: Selbst komprimiert braucht Qwen3-235B mehr als die 128 GB, die jeder von ihnen hat.
RDMA (Remote Direct Memory Access) erlaubt es einem Rechner, den Speicher eines anderen zu lesen, ohne den üblichen Netzwerkstapel zu durchlaufen. Dafür waren bisher Netzwerkkarten aus dem Rechenzentrum nötig. Laut Microsoft reichen jetzt Windows und ein USB4-Kabel. Eine kleine Nachricht braucht für Hin- und Rückweg 28 Mikrosekunden, rund viermal weniger als bei normalem Ethernet über dasselbe Kabel.
AMD testete drei Ryzen AI Max+ 395 mit je 128 GB, den Chip im GMKtec EVO-X2. Qwen3-235B schaffte dort 18,5 bis 21,98 Token pro Sekunde (ein Token entspricht etwa einem Wortstück). Intel ließ GPT-OSS-120B auf drei, dann vier PCs mit Core Ultra Series 3 und 64 GB laufen: 49,4 beziehungsweise 54,2 Token pro Sekunde.
Wie schlägt sich das gegen Nvidia?
Bei Nvidia ist die Kopplung ein Verkaufsargument. Der DGX Spark hat einen ConnectX-7-Netzwerkchip mit 200 Gb/s, zwei Geräte genügen für Modelle bis 405 Milliarden Parameter. USB4 schafft 40 oder 80 Gb/s, bei 40 also fünfmal weniger, kostet aber nichts extra. Die Latenz, die die Textausgabe taktet, ist laut Microsoft bei beiden Geschwindigkeiten gleich.
Lassen sich AMD, Intel und Arm mischen?
Das weiß noch niemand. Jeder PC muss direkt mit allen anderen verbunden sein: Zwei USB4-Ports reichen für ein Trio, vier Ports für fünf Geräte. Microsoft hat nur gleichartige Gruppen mit denselben Windows-Versionen und Treibern validiert und erwähnt Arm nirgends. Das angepasste llama.cpp läuft über Vulkan, das GPUs von AMD, Intel und Nvidia verstehen. Theoretisch ist Mischen also denkbar.
In keinem öffentlichen Windows-Build steckt die Funktion bisher. Microsoft verspricht bald eine Insider-Version, nur das NetworkDirect-Modul und das angepasste llama.cpp liegen auf GitHub. Außerdem muss Secure Boot abgeschaltet werden. Apple bietet RDMA über Thunderbolt 5 zwischen Macs seit macOS 26.2.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
INFOBAR ZERO: Das Smartphone, auf dem das Internet kaum vorkommt
Tesla FSD in Italien erlaubt: das 12. EU-Land sagt Ja
Robert Pattinson bei Google suchen: Das steckt hinter dem Bond-Gag
Kakao-Chefin Jung Shin-ah will nach Freispruch Fokus auf KI
Mehr aus: Software
Alle anzeigen →
Microsoft To Do wird im Sommer 2027 eingestellt, Planner soll folgen
Windows Baseline Protection: Apps prüfen, wie sicher Ihr PC ist
Apple Developer Academy: Roboter Yangpaca nach 3 Monaten fertig