Timeweb Cloud Ausfall: Routing-Dienst startete nur halb neu
Der Timeweb-Cloud-Ausfall am 17. November dauerte knapp zwei Stunden. Die Server liefen weiter, waren aber nicht erreichbar. Schuld war ein Sicherheitsupdate.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Beim Timeweb-Cloud-Ausfall am 17. November liefen die virtuellen Server die ganze Zeit weiter. Sie waren nur nicht mehr erreichbar. Der Hosting-Anbieter hat nun erklärt, warum: Ein Dienst wurde bei einem Update nur zur Hälfte neu gestartet.
Zwischen 13:18 und 15:05 Uhr Moskauer Zeit reagierten Websites und VPS-Ressourcen (virtuelle Server) von Timeweb-Kunden nicht mehr. Betroffen waren Sankt Petersburg, Moskau, Deutschland, die Niederlande und Kasachstan. Nur Nowosibirsk blieb verschont.
Was war die Ursache des Timeweb-Ausfalls?
Ingenieure aktualisierten den Netzwerk-Stack der Hypervisoren, also der Software-Schicht, die virtuelle Maschinen betreibt, um die Sicherheit zu erhöhen. Dabei startete der Dienst für dynamisches Routing nicht vollständig neu. Die Hypervisoren konnten ihre Routen deshalb nicht erneut an das Netzwerkgerät melden, und ein Teil der Server verlor die Netzanbindung. Die virtuellen Server selbst liefen weiter.
So verlief die Wiederherstellung
Laut Unternehmen begannen die Probleme um 13:18 Uhr. Um 13:28 Uhr hatten die Techniker die Ursache eingegrenzt und begannen mit der Reparatur. Um 13:47 Uhr meldete Timeweb Störungen in den Zonen SPB, MSK, DE, NL und KZ. Die Lösung war ein kompletter Neustart des Netzwerk-Stacks der Hypervisoren, danach funktionierte das Routing wieder. Um 14:17 Uhr waren die meisten Server wieder erreichbar, um 15:05 Uhr war alles hergestellt.
Die erste öffentliche Meldung vor dem Postmortem nannte nur ein Problem an der Netzwerkhardware und kündigte eine spätere Analyse an.
Was Timeweb ändern will
Drei Maßnahmen nennt das Unternehmen. Nach Hypervisor-Updates sollen alle Komponenten des Routing-Dienstes geprüft werden, nicht nur der Dienst insgesamt. Die Pausen zwischen den Update-Schritten werden verlängert, damit ein Fehler auffällt, bevor die nächsten Knoten drankommen. Und die Wiederherstellung des Netzwerk-Stacks soll bei ähnlichen Störungen schneller gehen.
Für Kunden bleibt eine bekannte Lehre: Ein laufender Server ist noch lange kein erreichbarer Server.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →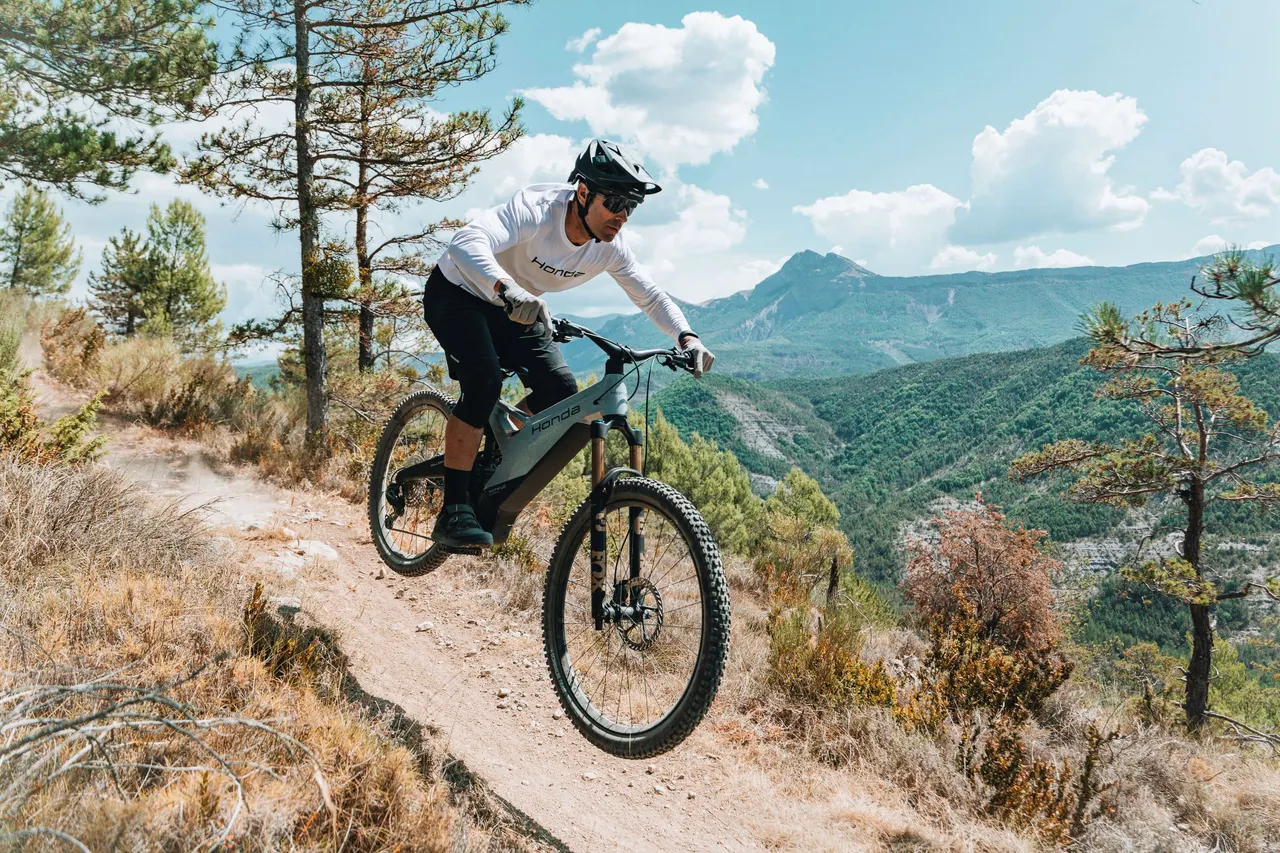
Honda RN0: Das erste E-MTB des Motorradbauers wiegt 24 Kilo
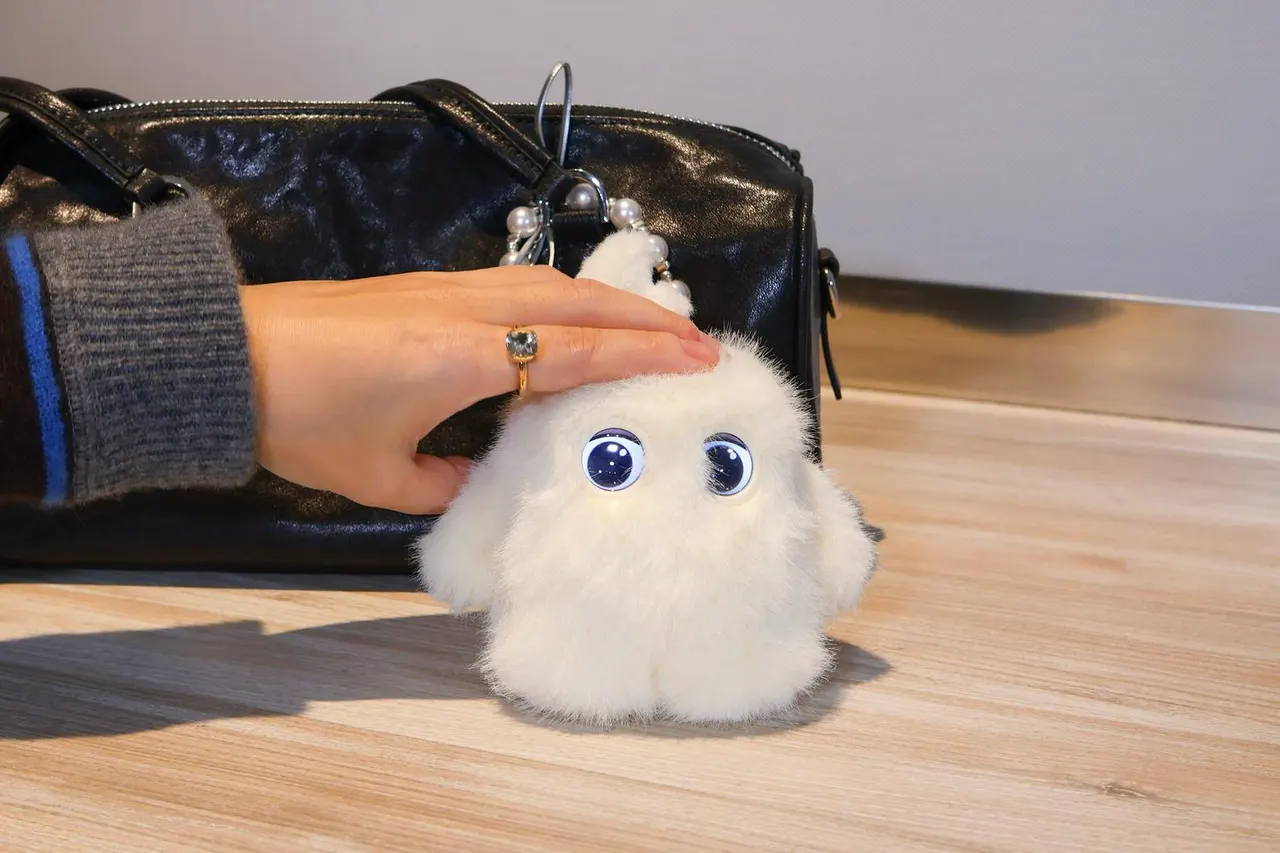
SwitchBot KATA Friends mini: Flauschiger KI-Begleiter für Smart Home
KI-Avatar auf YouTube: 100 Dislikes, 10 Likes für den Klon
Windows 11 erkennt Codex und Claude, sogar eine umbenannte cmd.exe
Mehr aus: Web & Dev
Alle anzeigen →
YouTube-Video gesperrt: Musikerin kämpft um gemeinfreies Volkslied
Robert Pattinson bei Google suchen: Zitronenschale rieselt
Archive of Our Own ist wieder online, nach über zwei Wochen