Takeout X-Ray wertet 500-MB-Chatarchive im Browser aus, ohne Server
Takeout X-Ray analysiert riesige Exporte von Telegram, ChatGPT, Spotify oder Chrome direkt im Browser-Tab. Es wird nichts hochgeladen, ein Backend gibt es nicht.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Ein Entwickler wollte ein „Spotify Wrapped“ für seine alten Telegram-Chats, ChatGPT-Gespräche und den Browserverlauf. Herausgekommen ist Takeout X-Ray, eine Web-App, die gigabyteschwere Exporte verarbeitet, ohne ein einziges Byte an einen Server zu schicken.
Die Version 2.0 versteht 12 Dienste und 13 Exportformate: Telegram, WhatsApp, Discord, X (Twitter), Spotify, YouTube, TikTok, Chrome, ChatGPT, Claude.ai sowie lokale Logs von Claude Code und Antigravity. Im Hintergrund läuft DuckDB-Wasm, eine zu WebAssembly kompilierte Datenbank, in einem eigenen Web Worker. Eine Live-Demo mit synthetischen Daten ist online, der Code liegt auf GitHub.
Wie funktioniert Takeout X-Ray ohne Backend?
Der Autor hat sich zwei feste Regeln gesetzt. Erstens: kein Backend. Private Nachrichten und Prompts für ein paar Diagramme hochzuladen wirkt zweifelhaft, auch mit dem Hinweis „wir speichern nichts“. Zweitens: kein await file.text() mit anschließendem JSON.parse(). Ein vollständiger Telegram-Export wiegt schnell 300 bis 700 MB und lässt den Tab mit einem Speicherfehler abstürzen.
Bei .zip-Dateien liest die App nur das Central Directory, also das Inhaltsverzeichnis am Ende des Archivs. Gigabyte an Videos und Bildern werden gar nicht angefasst. Enthält ein Google-Takeout-Archiv mehrere Dienste, fragt die Oberfläche nach, welcher ausgewertet werden soll. Die gewählte Datei geht in 64-KB-Häppchen an den Parser.
Das Format erkennt die App an den ersten Bytes, mit einem Fenster, das von 64 KB auf bis zu 4 MB wächst. Das war nötig: Ein Telegram-Export kann vor der Chatliste über 80 KB Kontakte enthalten, und ein 16-KB-Fenster hielt solche Dateien fälschlich für unbekannt.
Ein Streaming-Parser macht aus jeder Nachricht einen flachen Datensatz und verwirft den ursprünglichen JSON-Knoten. In DuckDB landen die Daten in Paketen zu 5.000 Zeilen, denn einzelne Inserts sind zu langsam und ein riesiges Array frisst Arbeitsspeicher.
Eigenheiten echter Exporte
ChatGPT speichert eine Unterhaltung als gerichteten Graphen, nicht als Liste. Neu generierte Antworten und bearbeitete Prompts bleiben als Seitenzweige erhalten. Der Parser läuft vom letzten Knoten rückwärts, rekonstruiert den aktiven Verlauf, und die übrigen Knoten verraten, wie oft man Antworten neu erzeugt hat.
Die Archivdateien von X sind gar kein JSON, sondern JavaScript-Dateien, die mit window.YTD.tweets.part0 = [...] beginnen. Dieses Präfix wird im laufenden Betrieb entfernt.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
Korbgeflecht-Aale: 2,8 Millionen Tiere auf einem Tiefsee-Berg
Rotation Station: Spotify live scratchen mit DIY-Deck
Voyager 1 ist einen Lichttag von der Erde entfernt
Wylsacom hält 30 % an Immortal, dem Startup hinter dem KloKlo-Bot
Mehr aus: Software
Alle anzeigen →
Windows UserAssist: Dein PC protokolliert jede App seit 2000
Instagram Content Protection: Neues Tool findet geklaute Videos
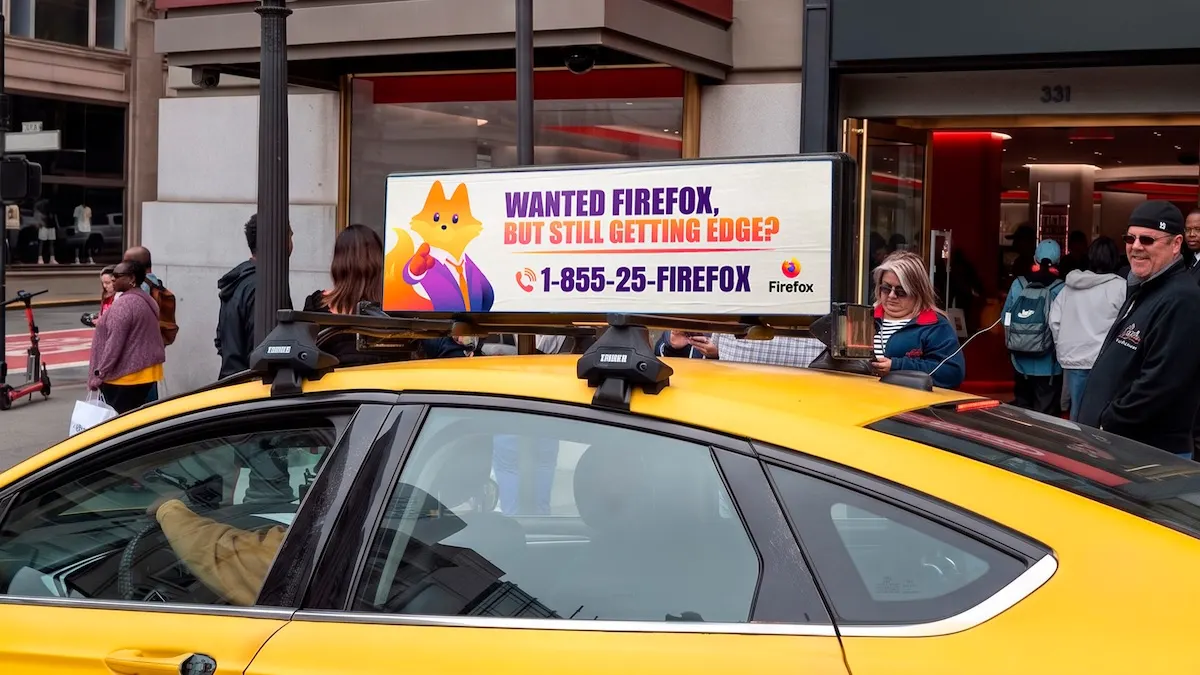
Mozilla-Hotline 1-855-25-FIREFOX: Beschwerden über Microsoft Edge