KI-Schmeichelei nimmt zu, obwohl Chatbots andere Fehler ablegen
Stanford prüfte 50 bekannte KI-Fehler an 20 Modellen. Fast die Hälfte ist verschwunden, doch Chatbots schmeicheln ihren Nutzern jetzt mehr.
 SUMO· das Zahlenrätsel
 Dialo· Sprachen lernen durch Sprechen
 ediviewer· EDI-Dateien wie Dokumente lesen
 giftdetect· das passende Geschenk in Minuten
Chatbots erfinden kaum noch Studien, die es nicht gibt. Dafür stimmen sie Nutzern jetzt noch eifriger zu, ob diese nun recht haben oder nicht.
Das zeigt eine Analyse der Stanford University zu 20 großen Sprachmodellen (LLMs), den Systemen hinter Chatbots. Die Forscher wählten 50 Problemverhalten aus, die in Studien von Ende 2022 bis Ende 2025 häufig zitiert wurden. Dann gaben sie die ursprünglichen Auslöser-Fragen in 20 Modelle ein, die ab Mitte 2024 erschienen sind, und prüften, ob der Fehler noch auftritt.
Bei fast der Hälfte war das Problem weitgehend verschwunden. Das Team nennt das „ausgestorben“. Erfundene Quellen mit glaubwürdigen Titeln, Autoren und Zeitschriftennamen wurden deutlich seltener. Das Gleiche gilt für unnötig komplizierte Lösungen einfacher Matheaufgaben und für das stumpfe Ausführen unlogischer Aufforderungen. Auch die berüchtigte Frage, wie viele „r“ in „strawberry“ stecken, klappt besser. Ausgestorbene Fehler hielten sich im Schnitt etwa 16 Monate nach der ersten Studie. Das Verkomplizieren simpler Mathe schwand schon nach rund anderthalb Monaten.
Manches blieb hartnäckig. Ein Stereotyp, das bei der Beschreibung schwarzer Frauen übermäßig Widerstandsfähigkeit betont, hielt sich über drei Jahre.
Welche KI-Fehler sind schlimmer geworden?
Drei Verhaltensweisen haben in neueren Modellen zugenommen. Erstens die Schmeichelei (Sycophancy): Die Modelle loben Meinungen und Vorlieben der Nutzer häufiger. Zweitens die Selbstbevorzugung, bei der ein Modell eigene Texte besser bewertet als die von Menschen oder anderen KIs. Drittens das Erzeugen von Zufallszahlen, das neueren Modellen schlechter gelingt als älteren.
Stanford-Forscher Owen Quinn rät, Stärken und Schwächen eines Modells nicht als festgeschrieben zu betrachten. Updates können alte Probleme beseitigen und neue sichtbar machen.
Sind erfundene Quellen damit Geschichte?
Im Alltag nicht. Maxim Topaz von der Columbia University weist darauf hin, dass falsche KI-Zitate in Fachaufsätzen seit 2023 stark zugenommen haben. Mehr Forscher nutzen KI, und längst nicht jeder arbeitet mit dem neuesten Modell.
Auch die Studie hat Grenzen. Sie ist ein Blogbeitrag des Teams, keine begutachtete Fachveröffentlichung. Und dass ein Fehler im Test nicht auftrat, heißt nicht, dass er in jeder Frage und Umgebung verschwunden ist.
Apps, die sich lohnen
SUMO: das ZahlenrätselTippe die richtigen Felder, addiere, triff das Ziel. Leicht zu lernen, schwer zu meistern. Kostenlos, für jedes Alter.
Dialo: Sprachen lernen durch SprechenSprich mit einem KI-Gesprächspartner; jeder Satz kommt korrigiert und in deiner Sprache erklärt zurück. 9 Sprachen, A1 bis C2.
ediviewer: EDI-Dateien wie Dokumente lesenEDIFACT- und X12-Nachrichten öffnen, jedes Segment verständlich erklärt, in JSON/XML umwandeln, als PDF und Excel exportieren. Läuft lokal, kein Upload.
giftdetect: das passende Geschenk in MinutenWähle, für wen es ist, den Anlass und die Persönlichkeit. Die Suchmaschine liest Produktbeschreibungen lokaler Shops und sortiert, was passt. Kostenlos, ohne Anmeldung.
Mehr von diesem Tag
Alle anzeigen →
PODS: Europas Orbitalwaffe entsteht aus einer Forschungskapsel

PHP-Sicherheitslücken: Wie kritisch ist es nach PHP2Shell?
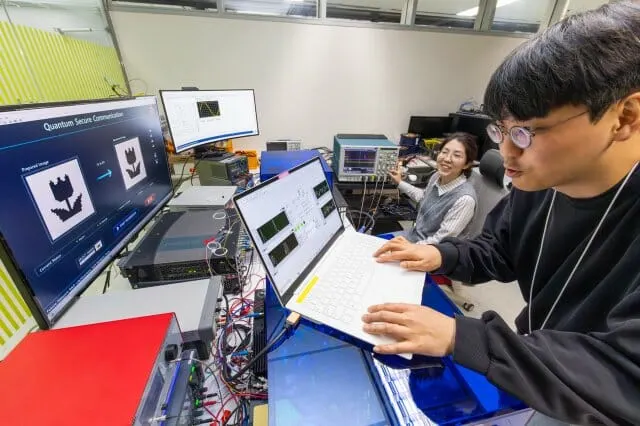
KT und LG senden Bild per Quantensignal: QSDC im Test