تدريب Tesseract 5 على لغة المانسي يخفض أخطاء OCR بنحو 20 مرة
درّب باحثون روس محرك Tesseract 5 المفتوح على النصوص المطبوعة بلغة المانسي، فانخفضت نسبة الأحرف الخاطئة من 18.5% إلى 0.85%. النموذج متاح مجانًا على Hugging Face.
درّب معهد يوغرا لتقنيات المعلومات (ЮНИИИТ) محرك التعرف الضوئي على الحروف المفتوح المصدر Tesseract 5 على قراءة النصوص المطبوعة بلغة المانسي. ووفق الفريق، انخفضت نسبة الأحرف الخاطئة من 18.5% إلى 0.85%، أي نحو 20 مرة. والنموذج متاح مجانًا على منصة Hugging Face.
لماذا يفشل OCR القياسي
تعتمد كتابة المانسي على الأبجدية السيريلية، لكنها تضم رموزًا خاصة: حروفًا متحركة طويلة بعلامة الماكرون مثل а̄ وо̄ وӯ وэ̄ وы̄، إضافة إلى الحرف ӈ الذي يمثل صوت «نغ». وطول الحرف المتحرك مهم في المانسي، لذلك قد يؤدي فقدان الماكرون إلى تحويل كلمة إلى أخرى. أما النموذج الروسي القياسي في Tesseract فلا يعرف هذه الرموز؛ إذ يُسقط الخط فوق الحرف وقد يحوّل الحرف إلى رمز عشوائي، ويخطئ في نحو 18 رمزًا من كل 100 في النص المانسي.
وثمة مشكلة أقل وضوحًا في Unicode: يمكن كتابة الحرف نفسه مع الماكرون بطرق مختلفة، إما برمز واحد جاهز أو بحرف عادي مع ماكرون منفصل. يراها القارئ متطابقة، لكنها بالنسبة للنموذج تسلسلان مختلفان.
بيانات اصطناعية بدل الصور الممسوحة
لا توجد مجموعة جاهزة من مسوحات المانسي بالحجم المطلوب، والتوسيم اليدوي سيستغرق سنوات. لذلك ولّد الفريق البيانات بنفسه: أخذ نصوصًا حقيقية من إصدارات مطبوعة وإلكترونية، وطبّعها وفق صيغة Unicode NFC، ثم رسمها بسكربتات Python. استُخدمت عشرات الخطوط، منها FreeSerif وDejaVu Sans وArial وCalibri وTimes New Roman، بأحجام 12 و14 و24 و26 نقطة وبأنماط عادية وعريضة ومائلة.
ووُضع إطار لكل رمز في ملفات box. ولأن الحسابات التلقائية تخطئ غالبًا في الماكرون البارز فوق السطر، أضاف الفريق تصحيحات على مستوى البكسل عبر ثلاثة قواميس: CHAR_OFFSETS وCHAR_SIZE وRATE. وبلغ الناتج 1.3 مليون زوج من الملفات: صورة السطر بصيغة .tif وملف .gt.txt يحوي النص الصحيح.
واعتمد الفريق نموذج rus.traineddata الروسي الرسمي من مستودع tessdata_best أساسًا، لأن أبجدية المانسي تتطابق تقريبًا مع الروسية، فيبقى على الشبكة تعلّم الحروف الجديدة. وكان المشروع قد جمع سابقًا 300 ألف جملة متوازية ودرّب مترجمًا عصبيًا بين الروسية والمانسي. ويهدف OCR إلى رقمنة الكتب والمناهج ومجموعات الفولكلور والصحف التي لا تزال ورقية في معظمها.
تطبيقات تستحق النظر
 SUMO: لغز الأرقام
اختر المربعات الصحيحة واجمعها وحقّق الهدف. سهل التعلم، صعب الإتقان. مجاني، لجميع الأعمار.
 Dialo: تعلّم اللغات بالتحدث
تحدّث مع شريك محادثة بالذكاء الاصطناعي؛ تعود كل جملة مصحّحة ومشروحة بلغتك. 9 لغات، من A1 إلى C2.
 ediviewer: اقرأ ملفات EDI كالمستندات
افتح رسائل EDIFACT وX12 مع شرح كل مقطع، وحوّلها إلى JSON/XML، وصدّرها إلى PDF وExcel. يعمل محليًا دون رفع.
المزيد من هذا اليوم
عرض الكل →
CyberKord تجمع 2.7 مليون يورو لأتمتة عمليات تقنية المعلومات والأمن السيبراني
كوهير المدعومة من إنفيديا تطلق مسرّعًا للذكاء الاصطناعي الدفاعي في سنغافورة
Quint Computing تجمع 9.1 ملايين يورو لتقليل أخطاء الرقائق الكمومية
Hypersonica تجمع 100 مليون يورو من Lightspeed وGeneral Catalyst
المزيد في: الذكاء الاصطناعي
عرض الكل →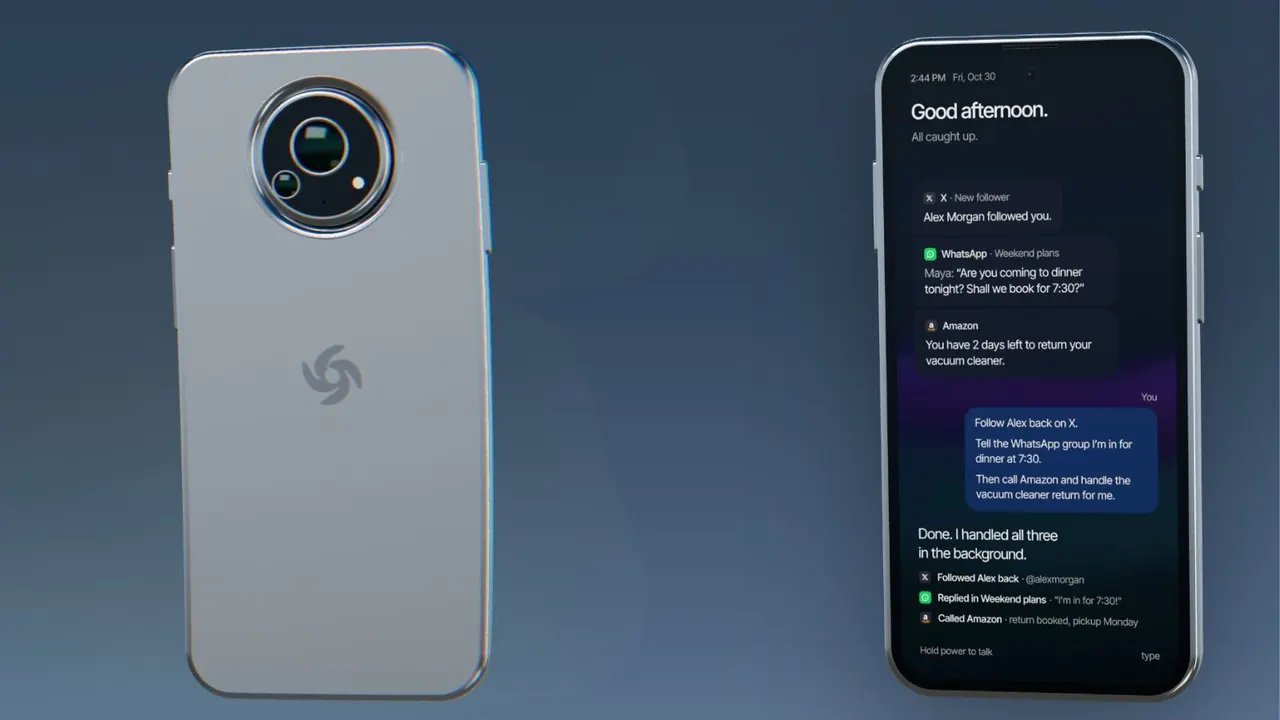
Cyclon تفتح الطلب المسبق لهاتف وكلاء ذكاء اصطناعي بـ699 دولارًا
OpenAI تضاعف حدود استخدام ChatGPT Pro وBusiness Premium
أبستيج تطلق Solar Pro 4 على منصة الذكاء الاصطناعي الحكومية في كوريا